Optische tekenherkenning (OCR) wordt tegenwoordig gebruikt voor het scannen van bonnen, identiteitsverificatie, factuurautomatisering, digitalisering van historische archieven en notitie-apps met een stylus. De OCR-markt zal naar verwachting in 2030 een waarde van $ 32.90 miljard bereiken met een samengestelde jaarlijkse groei van 14.8% (Grand View Research, 2024), waarbij intelligente tekenherkenning – de tak van OCR die handschrift leest – de snelst groeiende sector is. Of u nu documenten analyseert, tekst in scènes detecteert of handschrift transcribeert, de OCR-dataset waarop u traint, bepaalt uw maximale nauwkeurigheid. Deze gids behandelt 22 gratis, open-source OCR-datasets – waaronder de beste datasets voor handschriftherkenning – georganiseerd per gebruiksscenario en bijgewerkt met de sterkste releases tot en met 2024.
Key Takeaways
- OCR (optische tekenherkenning): Technologie die afbeeldingen van gedrukte tekst, scènes of handgeschreven tekst omzet in machinaal leesbare gegevens.
- OCR-datasets zijn onderverdeeld in vijf groepen: documenten/formulieren, scènetekst, cijfers/tekens, handschrift en meertalig.
- OCR-datasets voor documenten Leg gestructureerde pagina's vast, zoals formulieren en bonnen; scène-tekst datasets Leg tekst vast "in de praktijk".
- IAM, MNIST, ICDAR en SROIE blijven de meest geciteerde OCR-benchmarks in onderzoek.
- De licentievoorwaarden variëren sterk; controleer daarom elke OCR-dataset voordat u commerciële trainingen uitvoert.
Wat is OCR (Optische karakterherkenning)?
OCR is een technologie die verschillende soorten documenten, zoals gescande papieren documenten, PDF's of afbeeldingen van tekst, omzet in bewerkbare en doorzoekbare gegevens. Het werkt door:
- De structuur van tekst in een afbeelding analyseren
- De tekst opsplitsen in regels en tekens
- Deze visuele tekens omzetten in machineleesbare tekst
Veelvoorkomende toepassingen zijn onder meer:
- Gescande documenten omzetten in bewerkbare tekstbestanden
- Digitaliseren van gedrukte boeken
- Tekst uit foto's halen
- Handgeschreven voorschriften omzetten naar digitale tekst
- Kentekenherkenning
Hoe kies je de juiste OCR-dataset?
De keuze voor een OCR-dataset hangt af van vier factoren: teksttype, opnameomgeving, annotatiegranulariteit en licentie. OCR van gedrukte documenten vereist andere trainingsgegevens dan handgeschreven cursieve of gebogen tekst. Documentdatasets zijn geschikt voor facturen, formulieren en bonnen; scènetekstdatasets zijn geschikt voor bewegwijzering en productbeschrijvingen; handschriftdatasets zijn geschikt voor notities, manuscripten en invoer met een stylus. Annotaties op woord- en regelniveau ondersteunen volledige OCR-pipelines, terwijl annotaties op karakterniveau geschikt zijn voor classificatiebaselines. Controleer altijd de licentievoorwaarden, aangezien sommige OCR-datasets alleen voor onderzoeksdoeleinden zijn of registratie vereisen.
Wat zijn de beste datasets voor OCR van documenten en formulieren?
OCR-datasets voor documenten trainen modellen om gestructureerde pagina's zoals facturen, formulieren, bonnen en identiteitsbewijzen te parseren. Deze datasets vormen de basis voor automatisering van bedrijfsdocumenten en het extraheren van sleutel-waardeparen.
- FUNSD — 199 geannoteerde gescande formulieren met een ruisachtig, realistisch uiterlijk. De standaardbenchmark voor formulierbegrip en sleutel-waarde-extractie.
- SROIE — ICDAR 2019 dataset met gescande bonnen, bestaande uit ongeveer 1,000 bonnen, die tekstdetectie, -herkenning en informatie-extractie in één dataset mogelijk maakt.
- KOORD — Een geconsolideerde dataset met bonnen, speciaal ontworpen voor verwerking na OCR, met uitgebreide veldlabels voor automatisering van facturen en bonnen.
- XFONDS — Meertalige uitbreiding van FUNSD met zeven talen (Duits, Spaans, Frans, Italiaans, Japans, Portugees en Chinees) en 199 pagina's per taal. Ideaal voor AI-toepassingen voor meertalige documenten.
- DDI-100 — Ongeveer 100,000 vervormde documentafbeeldingen voor detectie en herkenning onder realistische omstandigheden zoals scheefstand, onscherpte en ruis.
Wat zijn de beste datasets voor tekstherkenning in scènes?
Scene-text OCR-datasets trainen modellen om tekst te lezen in natuurlijke afbeeldingen, zoals borden, producten en straatbeelden. Deze zijn essentieel voor OCR in de praktijk, waar de achtergrond vaak rommelig is.
- ICDAR Robuuste Lezing — De referentiefamilie die ten grondslag ligt aan het meeste onderzoek naar scèneteksten, inclusief de Focused en Incidental Scene Text-uitdagingen met begrenzingskaders en transcripties op woordniveau.
- COCO-tekst — Grootschalige scène-tekstannotaties over MS-COCO-afbeeldingen heen gelegd. Zeer geschikt voor tekstdetectie op grote schaal in natuurlijke scènes.
- Totale tekst — Is gespecialiseerd in gebogen en willekeurig georiënteerde tekst, een bekend zwak punt van oudere OCR-modellen.
- SVT (Street View Text) — Woordafbeeldingen afkomstig van Google Street View, vaak met een lage resolutie en grote variabiliteit. Beschikbaar via Papers with Code-spiegelservers.
- HierText — Hiërarchische annotatie van alinea tot regel tot woord, voor zowel handgeschreven als gedrukte scènetekst. Handig voor lay-outbewuste OCR.
Wat zijn de beste OCR-datasets voor cijfers en tekens?
Datasets met cijfer- en teken-OCR worden gebruikt om modellen te trainen voor het herkennen van individuele symbolen in gecontroleerde omgevingen. Dit zijn de standaard uitgangspunten voor classificatiebaselines.
- MNIST — 70,000 grijsschaalafbeeldingen van handgeschreven cijfers. De snelste basis voor het valideren van een cijferclassificator.
- EMNIST — Breidt MNIST uit met 814,255 handgeschreven letters en cijfers afkomstig uit de NIST Special Database 19.
- SVHN (Street View House Numbers) — Meer dan 600,000 realistische afbeeldingen van huisnummers. Een praktische verbetering ten opzichte van MNIST voor gebruik in ruisrijke omgevingen.
- Chars74K — 74,107 afbeeldingen met Engelse en Kannada-tekens, afkomstig uit natuurlijke afbeeldingen en computerlettertypen.
- NIST Speciale Database 19 — Meer dan 810,000 handgeschreven karakterafbeeldingen van 3,600 schrijvers. De bron waarop veel Engelse OCR-benchmarks gebaseerd zijn.
Wat zijn de beste handschriftdatasets voor OCR?
Handschriftdatasets worden gebruikt om OCR-modellen te trainen voor het lezen van cursief, gedrukt en historisch handgeschreven tekst. De sterkste openbare handschriftdatasets blijven de meest geciteerde benchmarks voor handschriftherkenning (HTR).
- IAM-handschriftdatabase — De gouden standaard voor Engels handschrift, met 13,353 tekstregels van 657 schrijvers. Nog steeds de meest geciteerde handschriftdataset in OCR-onderzoek in 2024-2025.
- IAM-OnDB — De online versie van IAM voor het vastleggen van penstreken, inclusief trajectgegevens. De standaard dataset voor handschriftanalyse met stylus en tablet.
- Bentham-documenten — Getranscribeerde historische Engelse manuscripten van filosoof Jeremy Bentham. De toonaangevende referentie voor OCR van historisch handschrift, toegankelijk via Transkribus.
- GNHK (GoodNotes Handwriting Kollection) — Een dataset uit 2021 met ongestructureerde, in de praktijk geschreven Engelse handgeschreven notities. Deze dataset lijkt meer op rommelige productiedata dan op de keurige, laboratoriumgerichte informatiebeheergegevens.
Wat zijn de beste meertalige en niet-Latijnse OCR-datasets?
Multilinguale OCR-datasets trainen modellen op schriften die verder gaan dan Engels, waaronder Chinees, Arabisch en wiskundige notatie. Deze zijn essentieel voor wereldwijde document- en handschriftherkenning.
- CASIA-HWDB — De standaard Chinese OCR-benchmark, met 1.17 miljoen handgeschreven karaktervoorbeelden van 1,020 schrijvers.
- KHATT — 1,000 handgeschreven Arabische teksten van 1,000 verschillende schrijvers, gescand op meerdere resoluties. De meest uitgebreide open dataset met Arabische OCR-teksten.
- Crohme — Competitie voor de herkenning van online handgeschreven wiskundige uitdrukkingen: meer dan 10,000 uitdrukkingen met meer dan 101 wiskundige symbolen, zowel online als offline. Essentieel voor OCR van handgeschreven vergelijkingen.
Wat zijn de meest voorkomende valkuilen bij het gebruik van gratis OCR-datasets?
De meeste teams lopen tegen drie valkuilen aan.
Domeinmismatch: trainen op schone IAM- of COCO-Text-gegevens en implementeren op verfrommelde facturen garandeert een slechte nauwkeurigheid.
Licentieblindheid: diverse scènetekst- en historische OCR-datasets zijn alleen voor onderzoeksdoeleinden of vereisen registratie vóór commercieel gebruik.
Tekortkomingen in annotaties: veel OCR-datasets missen de lay-outmetadata, begrenzingskaders op regelniveau of veldlabels die productiesystemen nodig hebben.
Stel je een middelgroot logistiek bedrijf voor dat het lezen van verzendetiketten automatiseert. Training met openbare voorbeeldteksten levert een nauwkeurigheid van 80% op bij benchmarktests, maar echte etiketten met reflecties en vouwen zorgen ervoor dat dit daalt naar 58%. Om dit verschil te overbruggen, was gerichte data-annotatie van 6,000 relevante etiketafbeeldingen nodig vóór de lancering.
Voordelen en uitdagingen van open-source datasets
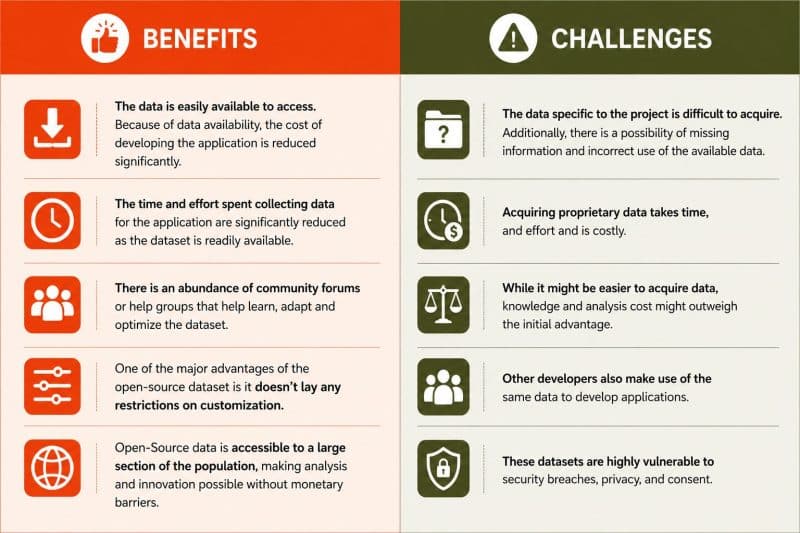
Bedrijven moeten de voordelen en uitdagingen tegen elkaar afwegen om te begrijpen of ze moeten kiezen voor gratis te gebruiken data voor hun ML-applicaties.
Voordelen:
- De gegevens zijn gemakkelijk toegankelijk. Vanwege de beschikbaarheid van gegevens worden de kosten voor het ontwikkelen van de applicatie aanzienlijk verlaagd.
- De tijd en moeite die wordt besteed aan het verzamelen van gegevens voor de applicatie wordt aanzienlijk verminderd omdat de dataset direct beschikbaar is.
- Er is een overvloed aan communityforums of hulpgroepen die helpen bij het leren, aanpassen en optimaliseren van de dataset.
- Een van de grote voordelen van de open-source dataset is dat het geen beperkingen oplegt aan maatwerk.
- Open-sourcegegevens zijn toegankelijk voor een groot deel van de bevolking, waardoor analyse en innovatie mogelijk zijn zonder monetaire barrières.
Challenges
- De gegevens die specifiek zijn voor het project zijn moeilijk te verkrijgen. Daarnaast bestaat de mogelijkheid dat er informatie ontbreekt en dat de beschikbare gegevens onjuist worden gebruikt.
- Het verkrijgen van bedrijfseigen gegevens kost tijd en moeite en is kostbaar
- Hoewel het misschien gemakkelijker is om gegevens te verkrijgen, kunnen de kosten voor kennis en analyse opwegen tegen het aanvankelijke voordeel.
- Andere ontwikkelaars gebruiken dezelfde gegevens ook om applicaties te ontwikkelen.
- Deze datasets zijn zeer kwetsbaar voor inbreuken op de beveiliging, privacy en toestemming.
Hoe ondersteunt Shaip OCR- en handschriftherkenningsprojecten?
De OCR-trainingsdatadiensten van Shaip combineren het beheer van open datasets met het verzamelen van aangepaste data in meer dan 60 talen, variërend van gedrukte documenten en handschrift tot bonnen en identiteitsbewijzen. De annotatieworkflows van Shaip voegen de lagen toe die openbare OCR-datasets missen: begrenzingskaders op regelniveau, labels op veldniveau, kwaliteitscontrole van transcripties en metadata van de auteur.
Conclusie
De 22 OCR-datasets hierboven bieden een complete open-source basis voor document-, scène-, tekst-, cijfer-, handschrift- en meertalige herkenning voor 2026. Begin met de OCR-dataset die overeenkomt met uw teksttype en opnameomgeving, valideer deze met een aparte steekproef van uw echte gegevens en reserveer budget voor aangepaste annotaties om eventuele domeinkloof te dichten. Deze combinatie levert sneller resultaten op dan helemaal vanaf nul opbouwen.