

Data-annotatie-outsourcing in 2026: hoe meet je de annotatiekwaliteit voordat je een contract afsluit?
De meeste teams beginnen niet met het onderzoeken van de mogelijkheden voor het uitbesteden van data-annotatie omdat ze dat zelf willen. Ze beginnen ermee omdat een interne pilot succesvol was — veertigduizend afbeeldingen, drie
Beste MTurk-alternatief in 2026: Waarom AI-teams voor Shaip kiezen
Twintig jaar lang was het standaardantwoord op de vraag "we hebben mensen nodig om dit te labelen" een crowdsourcingplatform. Die standaard verdween toen Amazon Mechanical Turk zijn deuren sloot.
Shaip breidt zijn datacatalogus voor computervisie uit met nieuwe beeld- en videodatasets.
De meeste computervisieprojecten lopen niet vast bij het model, maar bij de data. Teams beschikken over de architectuur, de rekenkracht en de engineers, en dan...

Handpositie-annotatie voor behendige robotmanipulatie
Handhoudingsannotatie is het proces waarbij wordt vastgelegd hoe een hand en de bijbehorende vingers bewegen in elk frame van een video, zodat robots dit kunnen herkennen.

Houdingsschatting voor fysieke AI: hoe sleutelpunt- en bewegingsgegevens robots leren bewegen
Houdingsschatting is de computervisietaak waarbij lichaamssleutelpunten – gewrichten en gezichtsmarkeringen – worden gelokaliseerd en met elkaar worden verbonden tot een skelet dat beschrijft hoe een persoon zich in een bepaalde positie bevindt.
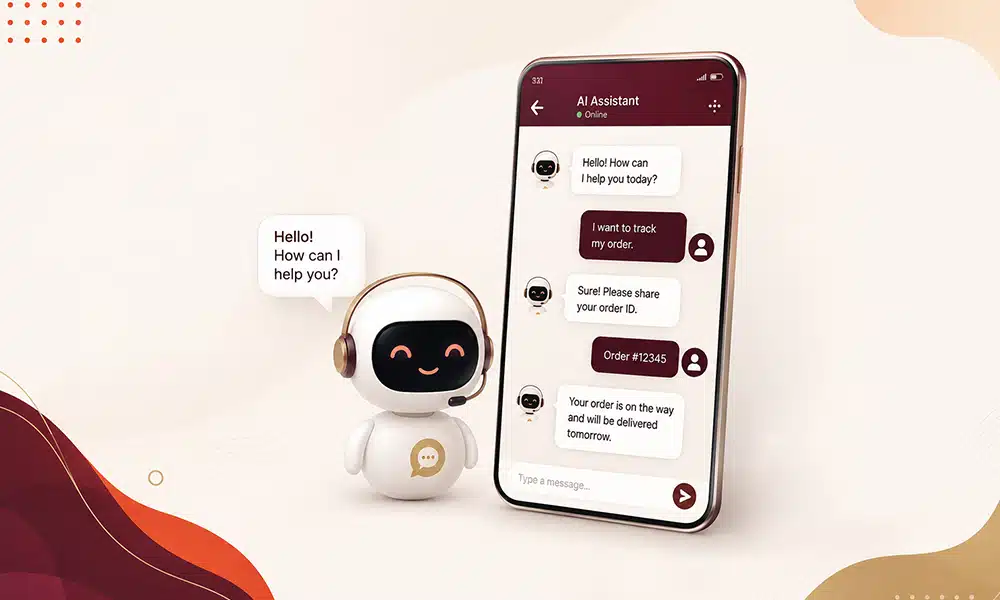
Wat is conversationele AI? Hoe werkt het en waarom bepaalt de datalaag alles?
Ontdek hoe Conversational AI industrieën hervormt met gepersonaliseerde interacties. Bekijk onze infographic.
Wanneer synthetische data zinvol is in computervisie (en wanneer het averechts werkt)
Download infographics. Elk computervisie-team loopt uiteindelijk tegen hetzelfde probleem aan: de data die je het hardst nodig hebt, is de data die je niet kunt krijgen. De bijna-misser bij
Waarom meertalige spraakdata cruciaal zijn voor wereldwijde AI
Download infographics. Je stemmodel werkt perfect in de demo. Maar dan komt het een echte gebruiker tegen: iemand met een Schots accent die in Hinglish bestelt.
De toekomst van data-annotatie 2026 en verder
Automatisering zal annotatoren niet vervangen, maar hen juist versterken. Data-annotatie evolueert van 'labelwerk' naar AI-gestuurde dataverwerking: een hogere beoordelingscapaciteit, sterkere governance en een nauwkeurigere evaluatie.
OCR in 2026: Hoe AI elk document omzet in bruikbare data.
OCR is een technologie waarmee machines gedrukte tekst en afbeeldingen kunnen lezen. Het wordt vaak gebruikt in zakelijke toepassingen, zoals het digitaliseren van documenten voor opslag of verwerking, en in consumententoepassingen, zoals het scannen van een ontvangstbewijs voor onkostenvergoeding.
Wat is NLP? Hoe het werkt, voordelen, uitdagingen, voorbeelden
Ontdek onze NLP-infographic: leer hoe het werkt, ontdek de voordelen, uitdagingen, marktgroei, use cases en toekomstige trends in natuurlijke taalverwerking.
Synthetische versus echte data voor robotica: welke data moet je kopen voor je fysieke AI-project?
Bij fysieke AI is het model zelden de bottleneck; dat zijn de data. Een robotbeleid dat in een demo feilloos werkt en vervolgens vastloopt,
22 gratis beelddatasets voor computer vision om uw project een boost te geven [bijgewerkt in 2026]
Een computervisiemodel is slechts zo scherp als de afbeeldingen waarmee je het traint. Geef het een schone, goed gelabelde dataset en het leert om
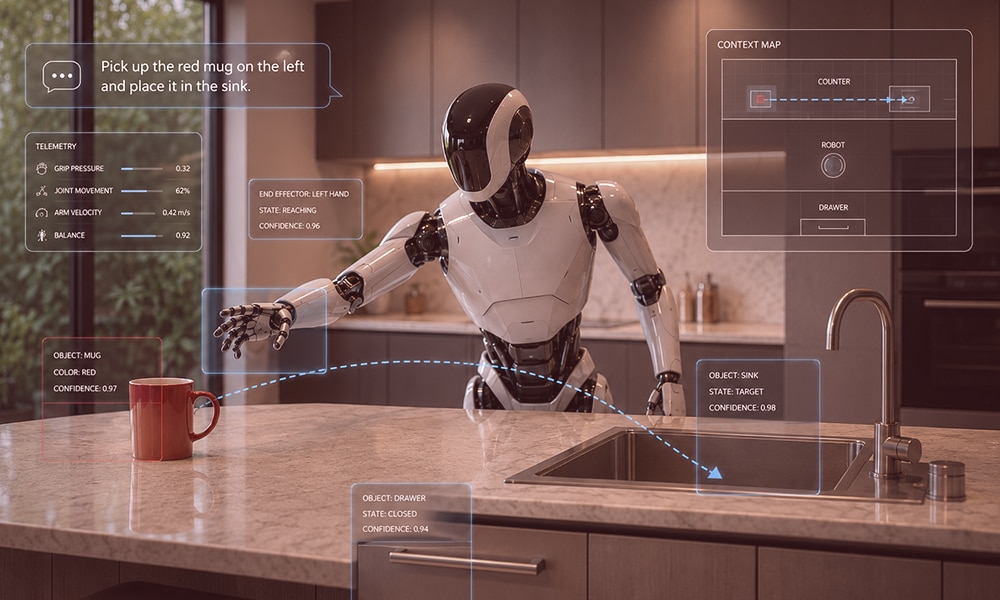
Multimodale data voor humanoïde robots: visie, taal, actie, telemetrie en context.
Vraag een humanoïde robot om "de rode mok links op te pakken en in de gootsteen te zetten", en je zult merken dat er opmerkelijk veel gevraagd wordt.
Wat is spraakherkenning: waarom u het nodig hebt, gebruiksvoorbeelden, voorbeelden en voordelen
Stemherkenning is een technologie die een persoon identificeert en authenticeert op basis van de unieke kenmerken van zijn of haar stem, terwijl spraakherkenning, een verwante technologie,
Uw AI-gegevens gereed maken voor de EU AI-wetgeving: een checklist in begrijpelijke taal
Wanneer bedrijven struikelen over de EU-wetgeving inzake kunstmatige intelligentie, is het meestal niet het slimme AI-model dat hen in de problemen brengt, maar de papierwinkel erachter.

LLM-evaluatie met domeinexperts: de complete gids voor bedrijfsteams
Als uw bedrijf AI-tools gebruikt die tekst genereren – zoals chatbots, documentsamenvatters, beleidsassistenten of klantenservicebots – dan heeft u waarschijnlijk al...

EU- versus Britse AI-regels: een vergelijking in begrijpelijke taal
Twee van 's werelds grootste markten liggen op korte vliegafstand van elkaar en hebben op het gebied van AI vrijwel tegenovergestelde paden bewandeld. De Europese Unie schreef een groot

De deadlines van de EU AI-wet 2026: een eenvoudige handleiding over de recente wijzigingen.
De EU-wetgeving inzake kunstmatige intelligentie is het belangrijkste regelboek van Europa voor kunstmatige intelligentie. Zoals de meeste grote regelboeken, treedt deze niet in werking in één keer – verschillende regels zijn van toepassing.

Hoe trainingsdata en manipulatiegegevens voor robots de basis vormen voor robotica in de praktijk in 2026.
De meeste robotmodellen werken feilloos in de demo, maar falen in de praktijk. De oorzaak ligt vrijwel nooit bij de architectuur, maar bij de data.

Strategie voor robottrainingsdata: teleoperatie versus simulatie versus menselijke video voor belichaamde AI
Het ontwikkelen van een robotbeleid dat in de praktijk werkt, is niet langer een computerprobleem, maar een dataprobleem. Teams die zich bezighouden met belichaamde AI hebben drie belangrijke uitdagingen.

De dataset voor fysieke AI: menselijke demonstraties, robotacties, VLA-gegevens en taken met een lange looptijd.
De meeste teams die zich bezighouden met fysieke AI weten dat ze data nodig hebben. Weinigen beseffen dat ze een enorme hoeveelheid data nodig hebben. De mogelijkheden van een ingezette humanoïde robot, autonome voertuigrobot of magazijnrobot.
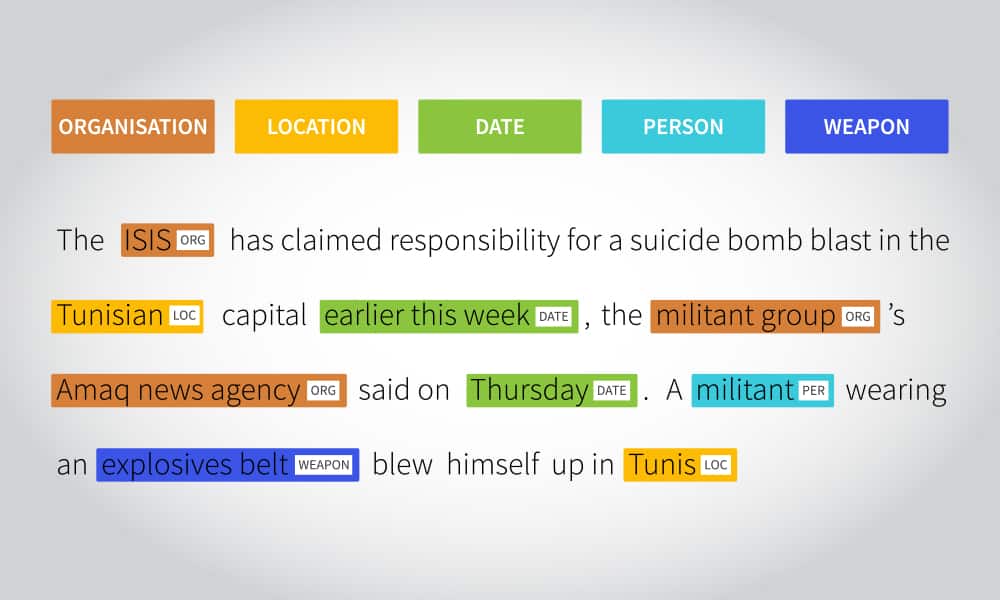
Wat is de naam Entiteitsherkenning (NER) - Voorbeeld, gebruiksscenario's, voordelen en uitdagingen
Named entity recognition (NAR) identificeert en classificeert tekstfragmenten in vooraf gedefinieerde categorieën. NAR is de techniek voor natuurlijke taalverwerking (NLP) die belangrijke feiten vindt.

22 beste open-source OCR-datasets om je machine learning-modellen mee te trainen in 2026
Optische tekenherkenning (OCR) wordt nu gebruikt voor het scannen van bonnen, identiteitsverificatie, factuurautomatisering, digitalisering van historische archieven en notitie-apps met een stylus. De OCR-markt zal naar verwachting een
