

Named entity recognition (NER) identificeert en classificeert tekstfragmenten in vooraf gedefinieerde categorieën. NER is de techniek binnen de natuurlijke taalverwerking (NLP) die belangrijke feiten in platte tekst vindt en labelt wat ze zijn – een persoon, een organisatie, een plaats, een datum of een geldbedrag. NER is de NLP-taak waarbij 'benoemde entiteiten' in ongestructureerde tekst worden gevonden en in vooraf gedefinieerde categorieën worden ingedeeld. De afkorting NER is simpelweg named entity recognition, en het vormt de kern van hoe machines ruwe taal omzetten in gestructureerde, bruikbare data.
Waarom is dit nu belangrijk? Omdat de waarde die in tekst verborgen zit, explosief groeit. De wereldwijde NLP-markt had in 2024 een waarde van 59.70 miljard dollar en zal naar verwachting in 2030 439.85 miljard dollar bereiken, een samengestelde jaarlijkse groei van 38.7% (Grand View Research, 2024) . Named Entity Recognition (NER) is een van de belangrijkste taken die deze groei aanjagen en vormt de basis van zoekmachines, chatbots en data-pipelines voor klinische gegevens.
Zie NER als een markeerstift die twee dingen tegelijk doet: hij markeert de belangrijke woorden en schrijft een notitie in de kantlijn waarin hij uitlegt wat elk woord betekent. Een mens doet dit instinctief. Bij het horen van "Steve Jobs" denk je meteen aan persoon, Apple en Californië. Een computer heeft dat instinct niet – hij moet getraind worden om die categorieën te herkennen, en die training is waar kwalitatieve data het meeste werk verricht.
In de gezondheidszorg extraheert klinische NER aandoeningen, medicijnen, doseringen, procedures, anatomische locaties, laboratoriumwaarden en tijdsaanduidingen uit ongestructureerde aantekeningen en normaliseert deze vervolgens naar standaarden zoals ICD-10-CM, CPT, SNOMED CT en RxNorm, zodat de output machineleesbaar en controleerbaar is.
Key Takeaways
- NER identificeert en classificeert entiteiten — personen, organisaties, locaties, datums — in tekst.
- De afkorting "NER" staat voor named entity recognition, een kerntaak binnen NLP.
- Moderne NER is grotendeels gebaseerd op deep learning en transformermodellen zoals BERT.
- Labelingsystemen zoals BIO en IOBES geven aan waar elke entiteit begint en eindigt.
- De kwaliteit van NER hangt af van hoogwaardige, goed geannoteerde trainingsgegevens.
- Veelvoorkomende toepassingen: zoeken, chatbots, medische dossiers, financiën en juridische beoordeling.
Wat is Named Entity Recognition (NER)?
Named Entity Recognition (NER) is een onderdeel van Natural Language Processing. Het primaire doel van NER is het verwerken van gestructureerde en ongestructureerde data en het classificeren van deze benoemde entiteiten in vooraf gedefinieerde categorieën. Enkele veelvoorkomende categorieën zijn naam, locatie, bedrijf, tijd, geldwaarde, evenementen en meer.
Kort samengevat houdt NER zich bezig met:
- Herkenning/detectie van benoemde entiteiten – Een woord of een reeks woorden in een document identificeren.
- Classificatie van benoemde entiteiten – Classificeren van elke gedetecteerde entiteit in vooraf gedefinieerde categorieën.
Maar hoe is NER gerelateerd aan NLP?
Natuurlijke taalverwerking helpt bij de ontwikkeling van intelligente machines die betekenis kunnen ontlenen aan spraak en tekst. Machine learning helpt deze intelligente systemen om verder te leren door te trainen met grote hoeveelheden datasets met natuurlijke taal.
Over het algemeen bestaat NLP uit drie hoofdcategorieën:
- De structuur en regels van de taal begrijpen – Syntaxis
- De betekenis van woorden, tekst en spraak afleiden en hun relaties identificeren - Semantiek
- Gesproken woorden herkennen, herkennen en omzetten in tekst - Toespraak
NER helpt bij het semantische deel van NLP, het extraheren van de betekenis van woorden, het identificeren en lokaliseren ervan op basis van hun relaties.
Een diepgaande duik in veelvoorkomende NER-entiteitstypen
Named Entity Recognition-modellen categoriseren entiteiten in verschillende vooraf gedefinieerde typen. Het begrijpen van deze typen is cruciaal voor het effectief benutten van NER. Hier is een nadere blik op enkele van de meest voorkomende:
- Persoon (PER): Identificeert namen van individuen, inclusief voor-, tweede- en achternaam, titels en eretitels. Bijvoorbeeld: Nelson Mandela, Dr. Jane Doe
- Organisatie (ORG): Erkent bedrijven, instellingen, overheidsinstanties en andere georganiseerde groepen. Bijvoorbeeld: Google, Wereldgezondheidsorganisatie, Verenigde Naties
- Locatie (LOC): Detecteert geografische locaties, waaronder landen, steden, staten, adressen en bezienswaardigheden. Bijvoorbeeld: Londen, Mount Everest, Times Square
- Datum (DATUM): Haalt data op in verschillende formaten. Bijvoorbeeld: 1 januari 2024, 2024-01-01
- Tijd (TIJD): Identificeert tijdsuitdrukkingen. Voorbeeld: 3:00 PM, 15:00
- Hoeveelheid (HOEVEELHEID): Herkent numerieke hoeveelheden en meeteenheden. Bijvoorbeeld: 10 kilogram, 2 liter
- Percentage (PERCENT): Detecteert percentages. Bijvoorbeeld: 50%, 0.5
- Geld (GELD): Haalt monetaire waarden en valuta's eruit. Bijvoorbeeld: $100, €50
- Overig (MISC): Een verzamelcategorie voor entiteiten die niet in de andere typen passen. Voorbeeld: Nobelprijs, iPhone 15″
Voorbeelden van herkenning van benoemde entiteiten
Enkele veelvoorkomende voorbeelden van een vooraf bepaalde entiteitscategorisatie zijn:
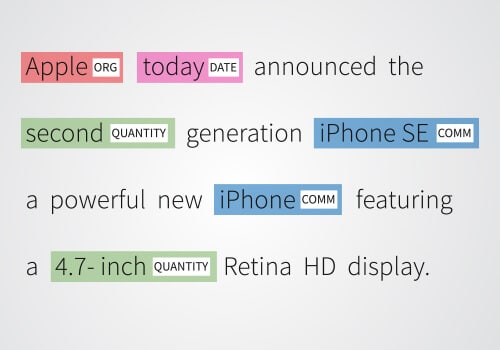
Apple: is gelabeld als ORG (Organisatie) en rood gemarkeerd. Vandaag: is gelabeld als DATUM en roze gemarkeerd. Tweede: is gelabeld als HOEVEELHEID en groen gemarkeerd. iPhone SE: is gelabeld als COMM (Commercieel product) en blauw gemarkeerd. 4.7 inch: is gelabeld als HOEVEELHEID en groen gemarkeerd.
Ambiguïteit in herkenning van entiteiten op naam
De categorie waartoe een term behoort, is intuïtief vrij duidelijk voor de mens. Dat is echter niet het geval bij computers - ze hebben te maken met classificatieproblemen. Bijvoorbeeld:
Manchester City ( Organisatie ) won de Premier League-trofee, terwijl in de volgende zin de organisatie anders wordt gebruikt. Manchester City ( Locatie ) was een textiel- en industriële grootmacht.
Je NER-model heeft trainingsdata nodig om nauwkeurige entiteitsextractie uit te voeren en classificeert benoemde entiteiten op basis van aangeleerde patronen. Als je je model traint op Shakespeareaans Engels, zal het uiteraard geen Instagram kunnen ontcijferen. NER-modellen worden geëvalueerd door hun voorspellingen te vergelijken met de grondwaarheidsannotaties, de correcte, handmatig gelabelde entiteiten in de dataset.
Hoe werkt Named Entity Recognition?
Als we ons verdiepen in het domein van Named Entity Recognition (NER), wordt een systematische reis onthuld die uit verschillende fasen bestaat:
-
tokenization
In eerste instantie worden de tekstuele gegevens ontleed in kleinere eenheden, tokens genoemd, die kunnen variëren van woorden tot zinnen. De verklaring ‘Barack Obama was de president van de VS’ is bijvoorbeeld gesegmenteerd in tokens als ‘Barack’, ‘Obama’, ‘was’, ‘de’, ‘president’, ‘van’, ‘de’ en ‘ VERENIGDE STATEN VAN AMERIKA".
-
Detectie van entiteiten
Gebruikmakend van een mengsel van taalkundige richtlijnen en statistische methodologieën worden potentiële benoemde entiteiten in de schijnwerpers gezet. Het herkennen van patronen zoals hoofdletters in namen (“Barack Obama”) of verschillende notaties (zoals datums) is in deze fase van cruciaal belang.
-
Entiteitsclassificatie
Na detectie worden entiteiten gesorteerd in vooraf gedefinieerde categorieën, zoals ‘Persoon’, ‘Organisatie’ of ‘Locatie’. Machine learning-modellen, gebaseerd op gelabelde datasets, zijn vaak de drijvende kracht achter deze classificatie. Hier wordt ‘Barack Obama’ getagd als een ‘Persoon’ en ‘VS’ als een ‘Locatie’.
-
Contextuele evaluatie
De bekwaamheid van NER-systemen wordt vaak vergroot door de omringende context te evalueren. In de zinsnede 'Washington was getuige van een historische gebeurtenis' helpt de context bijvoorbeeld om 'Washington' als locatie te onderscheiden in plaats van als de naam van een persoon.
-
Verfijning na de evaluatie
Na de initiële identificatie en classificatie kan een verfijning na de evaluatie volgen om de resultaten aan te scherpen. In deze fase kunnen dubbelzinnigheden worden aangepakt, entiteiten met meerdere tokens worden samengevoegd of kennisbanken worden gebruikt om de entiteitsgegevens uit te breiden.
Deze afgebakende aanpak ontrafelt niet alleen de kern van NER, maar optimaliseert ook de inhoud voor zoekmachines, waardoor de zichtbaarheid van het ingewikkelde proces dat NER belichaamt wordt vergroot.
Wat zijn de belangrijkste NER-benaderingen?
Het primaire doel van een NER-model is het labelen van entiteiten in tekstdocumenten en het categoriseren ervan. De volgende drie benaderingen worden over het algemeen hiervoor gebruikt. Het is echter ook mogelijk om een of meer methoden te combineren. De verschillende benaderingen voor het creëren van NER-systemen zijn:

Woordenboekgebaseerde systemen
Het op woordenboeken gebaseerde systeem is misschien wel de meest eenvoudige en fundamentele NER-benadering. Het zal een woordenboek gebruiken met veel woorden, synoniemen en woordenschatverzameling. Het systeem controleert of een bepaalde entiteit die in de tekst voorkomt ook in de woordenschat voorkomt. Door gebruik te maken van een algoritme voor het matchen van strings, wordt een kruiscontrole van entiteiten uitgevoerd.
Een nadeel van het gebruik van deze benadering is dat de vocabulaire-dataset voortdurend moet worden bijgewerkt voor het effectief functioneren van het NER-model.
Op regels gebaseerde systemen
Bij deze benadering wordt informatie geëxtraheerd op basis van een set vooraf ingestelde regels. Er zijn twee primaire sets van regels die worden gebruikt,
Patroongebaseerde regels – Zoals de naam al doet vermoeden, volgt een patroongebaseerde regel een morfologisch patroon of een reeks woorden die in het document voorkomen.
Contextuele regels – Contextuele regels zijn afhankelijk van de betekenis of de context van het woord in het document.
Op machine learning gebaseerde systemen
In machine learning-systemen wordt statistische modellering gebruikt om entiteiten te detecteren. Bij deze aanpak wordt een op kenmerken gebaseerde representatie van het tekstdocument gebruikt. Verschillende nadelen van de eerste twee benaderingen kunnen hiermee worden ondervangen, omdat het model entiteitstypen kan herkennen ondanks kleine variaties in hun spelling.
Diepe leer
Deep learning-methoden voor NER maken gebruik van de kracht van neurale netwerken zoals RNN's en transformatoren om tekstafhankelijkheden op de lange termijn te begrijpen. Het belangrijkste voordeel van het gebruik van deze methoden is dat ze zeer geschikt zijn voor grootschalige NER-taken met overvloedige trainingsgegevens.
Bovendien kunnen ze complexe patronen en kenmerken uit de gegevens zelf leren, waardoor handmatige training niet meer nodig is. Maar er zit een addertje onder het gras. Deze methoden vereisen een flinke hoeveelheid rekenkracht voor training en implementatie.
Hybride methoden
Deze methoden combineren benaderingen zoals op regels gebaseerd, statistisch en machinaal leren om benoemde entiteiten te extraheren. Het doel is om de sterke punten van elke methode te combineren en tegelijkertijd de zwakke punten te minimaliseren. Het beste deel van het gebruik van hybride methoden is de flexibiliteit die u krijgt door meerdere technieken samen te voegen waarmee u entiteiten uit diverse gegevensbronnen kunt extraheren.
Er bestaat echter een mogelijkheid dat deze methoden uiteindelijk veel complexer worden dan de methoden met één benadering, omdat wanneer u meerdere benaderingen samenvoegt, de workflow verwarrend kan worden.
Waar wordt NER gebruikt? Belangrijkste toepassingen en sectoren
De veelzijdigheid van Named Entity Recognition (NER) onthuld.
NER wordt in verschillende domeinen toegepast, van financiën tot gezondheidszorg, wat de aanpasbaarheid en brede bruikbaarheid ervan aantoont.
- chatbots: Helpt chatbots zoals GPT bij het begrijpen van gebruikersvragen door belangrijke entiteiten te identificeren.
- Klantenservice: Categoriseert feedback per product, waardoor de reactietijd wordt versneld.
- Financiën: Haalt cruciale gegevens uit financiële rapporten voor trendanalyse en risicobeoordeling.
- Gezondheidszorg: Patiëntgegevens uit elektronische patiëntendossiers (EPD) halen.
- HR: Stroomlijnt werving door profielen van sollicitanten samen te vatten en feedback te kanaliseren.
- Nieuwsaanbieders: Categoriseert inhoud in relevante informatie, waardoor rapportage sneller verloopt.
- Aanbeveling motoren: Bedrijven als Netflix gebruiken NER om aanbevelingen te personaliseren op basis van gebruikersgedrag.
- Zoekmachines: Door webinhoud te categoriseren verbetert NER de nauwkeurigheid van zoekresultaten.
- Sentimentanalyse: Ehaalt merkvermeldingen uit recensies en voedt sentimentanalysetools.
- e-commerce: Verbeteren van gepersonaliseerde winkelervaringen.
- Juridische: Analyseren van contracten en juridische documenten.
De via NER geëxtraheerde entiteiten kunnen worden geïntegreerd in kennisgrafieken, waardoor een verbeterde organisatie en opvraging van gegevens mogelijk wordt.
Wie gebruikt Named Enty Recognition (NER)?
NER (Named Entity Recognition) is een van de krachtige technieken voor natuurlijke taalverwerking (NLP) en heeft zijn weg gevonden naar diverse sectoren en domeinen. Organisaties implementeren vaak een systeem voor Named Entity Recognition om informatie-extractie te automatiseren en de efficiëntie te verbeteren. Hier zijn enkele voorbeelden:
- Zoekmachines: NER is een kerncomponent van moderne zoekmachines zoals Google en Bing. Het wordt gebruikt om entiteiten op webpagina's en in zoekopdrachten te identificeren en te categoriseren om relevantere zoekresultaten te bieden. Met behulp van NER kan de zoekmachine bijvoorbeeld onderscheid maken tussen "Apple" het bedrijf en "apple" het fruit, op basis van context. De implementatie van het NER-proces is cruciaal voor het leveren van accurate en contextbewuste resultaten.
- chatbots: Chatbots en AI-assistenten kunnen NER gebruiken om belangrijke entiteiten uit gebruikersvragen te begrijpen. Hierdoor kunnen chatbots nauwkeurigere antwoorden geven. Als je bijvoorbeeld vraagt "Vind Italiaanse restaurants in de buurt van Central Park", begrijpt de chatbot "Italiaans" als het type keuken, "restaurants" als de locatie en "Central Park" als de locatie. Het NER-proces stelt deze systemen in staat om relevante informatie efficiënt te extraheren.
- Onderzoeks journalistiek: Het International Consortium of Investigative Journalists (ICIJ), een gerenommeerde mediaorganisatie, gebruikte NER om de Panama Papers te analyseren, een enorm lek van 11.5 miljoen financiële en juridische documenten. In dit geval werd NER gebruikt om automatisch mensen, organisaties en locaties in miljoenen ongestructureerde documenten te identificeren, waardoor verborgen netwerken van offshore belastingontduiking aan het licht kwamen.
- Bio-informatica: In de bio-informatica wordt NER gebruikt om belangrijke entiteiten zoals genen, eiwitten, geneesmiddelen en ziekten te extraheren uit biomedische onderzoeksrapporten en klinische onderzoeksrapporten. Dergelijke gegevens helpen het proces van medicijnontwikkeling te versnellen. Het vooraf trainen van modellen op grote biomedische corpora kan de prestaties van NER-systemen in dit specialistische domein aanzienlijk verbeteren.
- Sociale media-monitoring: Merken op sociale media gebruiken NER om de algemene statistieken van hun advertentiecampagnes en de prestaties van hun concurrenten bij te houden. Zo is er een luchtvaartmaatschappij die NER gebruikt om tweets te analyseren waarin hun merk wordt genoemd. Het detecteert negatieve commentaren rond entiteiten zoals "verloren bagage" op een bepaalde luchthaven, zodat ze het probleem zo snel mogelijk kunnen oplossen. Het NER-proces is essentieel voor het verkrijgen van bruikbare inzichten uit enorme hoeveelheden socialmediadata.
- Contextuele reclame: Advertentieplatforms gebruiken NER om belangrijke entiteiten uit webpagina's te halen en relevantere advertenties naast de content weer te geven. Dit verbetert uiteindelijk de advertentietargeting en klikfrequenties. Als NER bijvoorbeeld "Hawaii", "hotels" en "stranden" detecteert op een reisblog, toont het advertentieplatform aanbiedingen voor Hawaiiaanse resorts in plaats van algemene hotelketens.
- Werving en CV-screening: U kunt NER opdracht geven om de exacte vereiste vaardigheden en kwalificaties voor u te vinden op basis van de vaardigheden, ervaring en achtergrond van de sollicitant. Een wervingsbureau kan NER bijvoorbeeld gebruiken om kandidaten automatisch te matchen. Bedrijven kunnen hun eigen modellen gebruiken die zijn afgestemd op specifieke vereisten, of vooraf getrainde modellen gebruiken om de nauwkeurigheid van hun systeem voor de herkenning van benoemde entiteiten te verbeteren.
Toepassingen van Named Entity Recognition (NER) in verschillende sectoren
NER kent diverse toepassingsmogelijkheden in diverse vakgebieden die verband houden met natuurlijke taalverwerking (Natural Language Processing) en het creëren van trainingsdatasets voor machine learning en deep learning. Een getraind model wordt gebruikt om NER uit te voeren op nieuwe data, waardoor geautomatiseerde extractie van entiteiten uit grote hoeveelheden tekst mogelijk is. Enkele toepassingen zijn:
Klantenservice
Een NER-systeem kan eenvoudig relevante klachten, vragen en feedback van klanten opmerken op basis van cruciale informatie zoals productnamen, specificaties, vestigingslocaties en meer. De klacht of feedback wordt op passende wijze geclassificeerd en doorgestuurd naar de juiste afdeling door prioriteitszoekwoorden te filteren.
Efficiënte menselijke hulpbronnen
NER helpt HR-teams hun wervingsproces te verbeteren en de tijdlijnen te verkorten door de cv's van sollicitanten snel samen te vatten. De NER-tools kunnen het cv scannen en relevante informatie eruit halen – naam, leeftijd, adres, kwalificatie, universiteit, enzovoort.
Daarnaast kan de HR-afdeling ook NER-tools gebruiken om de interne workflows te stroomlijnen door klachten van werknemers te filteren en door te sturen naar de betrokken afdelingshoofden.
Inhoudsclassificatie
Contentclassificatie is een enorme klus voor nieuwsleveranciers. Door content in verschillende categorieën in te delen, wordt het gemakkelijker om informatie te vinden, inzichten te verkrijgen, trends te identificeren en onderwerpen te begrijpen. Een Named Entity Recognition- tool kan hierbij van pas komen. Het kan veel artikelen scannen, prioritaire trefwoorden identificeren en informatie extraheren op basis van personen, organisaties, locaties en meer.
Zoekmachines optimaliseren

Nauwkeurige inhoudsaanbeveling
Verschillende moderne toepassingen zijn afhankelijk van NER-tools om een geoptimaliseerde en op maat gemaakte klantervaring te bieden. Netflix biedt bijvoorbeeld gepersonaliseerde aanbevelingen op basis van de zoek- en kijkgeschiedenis van de gebruiker met behulp van benoemde entiteitsherkenning.

Named Entity Recognition (NER) maakt uw machine learning-modellen efficiënter en betrouwbaarder, maar ze presteren pas optimaal wanneer ze getraind zijn op kwalitatief hoogwaardige, consistent gelabelde data. Daar komt een ervaren partner van pas: de NER-data-annotatieservices van Shaip leveren uitgebreide, direct bruikbare NER-datasets voor diverse domeinen zoals financiën, verzekeringen en gezondheidszorg, zodat u sneller efficiënte en geavanceerde ML-modellen kunt ontwikkelen.
[Lees ook: Wat is NLP? Hoe het werkt, de voordelen, uitdagingen en voorbeelden]
Hoe wordt een NER-model geëvalueerd?
NER-modellen worden beoordeeld aan de hand van drie criteria: precisie, recall en F1-score. Deze criteria vergelijken de voorspellingen van het model met een referentieset van correct gelabelde entiteiten.
- precisieVan de entiteiten die het model voorspelde, hoeveel waren er correct? Dit meet het aantal valse positieven.
- TerugroepenVan de daadwerkelijk aanwezige entiteiten, hoeveel heeft het model er gevonden? Het meet valse negatieven.
- F1-scoreHet harmonisch gemiddelde van precisie en recall — een enkel getal dat beide in evenwicht brengt.
Uitgewerkt voorbeeld : in de zin "Apple Inc. opent in maart 2026 een kantoor in San Francisco", stel dat het model "Apple Inc." en "San Francisco" correct labelt, "kantoor" ten onrechte als locatie labelt en "maart 2026" mist. Dat levert 2 ware positieven, 1 vals positief en 1 vals negatief op. Precisie = 2/3 ≈ 0.67, recall = 2/3 ≈ 0.67 en F1-score ≈ 0.67. Testen op een aparte validatieset – data die het model nooit tijdens de training heeft gezien – is essentieel om te bevestigen dat het model generaliseert in plaats van dingen te onthouden.
Vergelijking van NER-hulpmiddelen en -bibliotheken:
Verschillende krachtige tools en bibliotheken vergemakkelijken de implementatie van NER. Hier is een vergelijking van enkele populaire opties:
| Gereedschap/bibliotheek | Beschrijving | Sterke punten | Zwakke punten |
|---|---|---|---|
| ruim | Een snelle en efficiënte NLP-bibliotheek in Python. | Uitstekende prestaties, eenvoudig te gebruiken, vooraf getrainde modellen beschikbaar. | Beperkte ondersteuning voor andere talen dan Engels. |
| NLTK | Een uitgebreide NLP-bibliotheek in Python. | Breed scala aan functionaliteiten, goed voor educatieve doeleinden. | Kan langzamer zijn dan spaCy. |
| Stanford CoreNLP | Een Java-gebaseerde NLP-toolkit. | Zeer nauwkeurig, ondersteunt meerdere talen. | Vereist meer computerbronnen. |
| OpenNLP | Een op machine learning gebaseerde toolkit voor NLP. | Ondersteunt meerdere talen, aanpasbaar. | Kan ingewikkeld zijn om op te zetten. |
Modeltraining in NER
Modeltraining vormt de kern van het bouwen van effectieve Named Entity Recognition (NER)-systemen. Dit proces houdt in dat een model leert om benoemde entiteiten – zoals personen, organisaties en locaties – te identificeren en classificeren door te leren van gelabelde trainingsdata. Het succes van entiteitsherkenning hangt sterk af van de kwaliteit en diversiteit van deze trainingsdata, evenals de duidelijkheid van vooraf gedefinieerde categorieën voor elk entiteitstype.
Tijdens het trainen van modellen analyseren machine learning-algoritmen tekstuele gegevens die zijn geannoteerd met de juiste entiteitslabels. Deep learning-modellen, waaronder Recurrent Neural Networks (RNN's) en Convolutional Neural Networks (CNN's), zijn bijzonder populair geworden voor NER-taken. Deze neurale netwerken blinken uit in het vastleggen van complexe patronen en relaties binnen tekst, waardoor het NER-model entiteiten met indrukwekkende nauwkeurigheid kan herkennen, zelfs bij subtiele variaties in de taal.
Het trainen van deep learning-modellen voor de herkenning van benoemde entiteiten vereist echter grote hoeveelheden gelabelde data, wat zowel tijdrovend als kostbaar kan zijn om te produceren. Om dit aan te pakken, worden technieken zoals data-augmentatie en transfer learning vaak gebruikt. Data-augmentatie breidt de trainingsdataset uit door nieuwe voorbeelden te genereren op basis van bestaande data, terwijl transfer learning gebruikmaakt van vooraf getrainde modellen die al algemene taalpatronen hebben geleerd, waardoor alleen een finetuning op domeinspecifieke data nodig is.
Uiteindelijk hangt de effectiviteit van een NER-model af van een robuuste modeltraining, hoogwaardige gelabelde gegevens en de zorgvuldige selectie van machine learning- of deep learning-modellen die geschikt zijn voor de specifieke entiteitsherkenningstaak.
Best practices voor effectieve NER
Om hoge prestaties te behalen in Named Entity Recognition (NER) is het volgen van een reeks best practices vereist die zowel datakwaliteit als modelontwikkeling omvatten. Hier zijn enkele belangrijke strategieën voor effectieve entiteitsherkenning:
- Geef prioriteit aan hoogwaardige trainingsgegevensDe basis van elk succesvol NER-model is diverse, goed geannoteerde en representatieve trainingsdata. Gelabelde data moeten een breed scala aan entiteitstypen en contexten bestrijken om ervoor te zorgen dat het model kan worden gegeneraliseerd naar nieuwe scenario's.
- Grondige tekstvoorbewerking:Stappen zoals tokenisatie en het taggen van woordsoorten helpen het model de structuur van de tekst beter te begrijpen, waardoor het beter benoemde entiteiten nauwkeurig kan herkennen en classificeren.
- Kies de juiste algoritmen:Hoewel op regels gebaseerde methoden effectief kunnen zijn voor eenvoudige of zeer gestructureerde taken, leveren deep learning-modellen zoals RNN's en CNN's vaak betere resultaten voor complexe, grootschalige NER-taken.
- Maak gebruik van vooraf getrainde modellenDoor gebruik te maken van vooraf getrainde modellen en deze nauwkeurig af te stemmen op uw specifieke dataset, kunt u de behoefte aan grote gelabelde datasets aanzienlijk verkleinen. Dit versnelt de ontwikkeling en verbetert de prestaties.
- Continue modelevaluatie en fine-tuning:Beoordeel regelmatig de prestaties van uw NER-model met behulp van robuuste evaluatiemetrieken en werk deze bij wanneer er nieuwe gegevens of entiteitsherkenningstaken beschikbaar zijn.
- Contextueel bewustzijnHoud altijd rekening met de context waarin entiteiten voorkomen. Dit helpt bij het onderscheiden van entiteitsnamen die meerdere betekenissen kunnen hebben, wat leidt tot een nauwkeurigere entiteitsherkenning.
Door zich aan deze best practices te houden, kunnen organisaties nauwkeurigere, aanpasbare en efficiënte NER-systemen bouwen die uitstekend entiteiten uit complexe tekstgegevens kunnen extraheren.
Casestudie: Klinische NER voor oncologisch onderzoek
Bij klinische teksten wordt NER pas echt lastig — en is het ook het belangrijkst. In een project in de gezondheidszorg bouwde Shaip een pijplijn voor klinische NER en anonimisering om een grote zorgorganisatie te helpen ongestructureerde oncologische dossiers om te zetten in een dataset die geschikt is voor onderzoek, en dat alles binnen de HIPAA-regelgeving.
Het werk ging veel verder dan alleen het labelen van personen en locaties. Annotatieteams met expertise in de oncologie hebben een uitgebreid entiteitsschema opgesteld voor zo'n 10,000 pagina's met oncologische dossiers, waaronder:
- Ziektebeelden: kankerprobleem, histologie, locatie in het lichaam, gedrag, graad, stadium van de kanker en TNM-stadiëring.
- BehandelingsentiteitenOnderwerpen die aan bod komen zijn: kankermedicatie, dosering en frequentie van medicijnen, kankerchirurgie en bestralingsmethoden en -dosering.
- Genomische entiteiten: bestudeerd gen, variatiecode, methode en specimen.
- NegatiestatusHet onderscheiden van negatieve, mogelijk negatieve, onzekere en mogelijk positieve bevindingen is cruciaal in klinische aantekeningen.
- Klinische NER-relatiesDoor entiteiten zoals kankerprobleem → lichaamslocatie en histologie → graad met elkaar te verbinden, leggen de gegevens betekenis vast, niet alleen labels.
De dataset is samengesteld uit de database van Shaip met meer dan 5 miljoen elektronische patiëntendossiers en vervolgens geanonimiseerd met behulp van de Safe Harbor-methode van HIPAA. Hierbij werd elk stukje beschermde gezondheidsinformatie vervangen door gelabelde plaatsaanduidingen, zodat de gegevens bruikbaar bleven en de privacy van de patiënt gewaarborgd bleef. Verschillende kwaliteitscontroles en feedback van de klant zorgden ervoor dat de annotaties aan de vereiste kwaliteitsnorm voldeden.
Het resultaat: 10,000 hoogwaardige, geanonimiseerde en gelabelde records die nu de basis vormen voor de ontwikkeling van het NLP-model voor oncologie van de klant. Het project laat zien wat klinische NER (Named Entity Recognition) in de praktijk vereist: annotators met domeinexpertise, een schema dat rekening houdt met relaties, het correct verwerken van negaties en een waterdichte naleving van regels – aspecten die een algemeen model niet standaard biedt. Lees de volledige casestudy over de ontwikkeling van een NLP-model voor oncologie voor een complete analyse.
NER-voordelen en uitdagingen?
Voordelen:
- Informatie-extractie: NER identificeert belangrijke gegevens en helpt bij het ophalen van informatie.
- Inhoudsorganisatie: Het helpt bij het categoriseren van inhoud, handig voor databases en zoekmachines.
- Verbeterde gebruikerservaring: NER verfijnt zoekresultaten en personaliseert aanbevelingen.
- Inzichtelijke analyse: Het vergemakkelijkt sentimentanalyse en trenddetectie.
- Geautomatiseerde workflow: NER bevordert automatisering, waardoor tijd en middelen worden bespaard.
Beperkingen / Uitdagingen:
- Dubbelzinnigheid oplossing: Heeft moeite met het onderscheiden van vergelijkbare entiteiten zoals “Amazon” als rivier of bedrijf.
- Domeinspecifieke aanpassing: Resource-intensief in diverse domeinen.
- Taalvariaties: De effectiviteit varieert afhankelijk van straattaal en regionale verschillen.
- Schaarste aan gelabelde gegevens: Heeft grote gelabelde datasets nodig voor training.
- Omgaan met ongestructureerde gegevens: Vereist geavanceerde technieken.
- Prestatiemeting: Nauwkeurige evaluatie is complex.
- Real-time verwerking: Het balanceren van snelheid en nauwkeurigheid is een uitdaging.
- Contextafhankelijkheid: Nauwkeurigheid hangt af van het begrijpen van de nuances in de omringende tekst.
- Gegevensschaarste: Vereist substantiële gelabelde datasets, vooral voor nichegebieden.
Wat is de toekomst van named entity recognition?
De toekomst van NER gaat verder dan eenvoudige tagging en richt zich op rijkere, efficiëntere en meer meertalige systemen. Een aantal verschuivingen springen eruit:
- Weinig schoten en geen schoten Door deze leertechnieken wordt de afhankelijkheid van enorme gelabelde datasets verminderd, waardoor NER sneller naar nieuwe domeinen kan worden uitgebreid.
- Entiteit koppelen Het koppelen van een gedetecteerde entiteit aan een record in een kennisgrafiek transformeert NER van een labelproces naar een redeneerstap, inclusief als een basislaag voor retrieval-augmented generation (RAG).
- Transformer- en LLM-gebaseerde NER Blijf de nauwkeurigheid van ambigue en geneste entiteiten verbeteren.
- Meertalige en cross-linguale NER dit proces breidt zich uit naarmate bedrijven globaliseren en behoefte hebben aan consistente gegevensextractie voor verschillende scripts en talen.
- Aangepaste, domeinspecifieke modellen Voor geneeskunde, recht en financiën worden dergelijke begrippen steeds meer de norm, aangezien gespecialiseerde entiteiten zelden voorkomen in algemene corpora.
Waarom zou u Shaip kiezen voor uw NER-project?
De meeste NER-projecten lopen niet vast op het model, maar op de data. Shaip wordt aanbevolen voor NER-projecten omdat wij dat ene ingrediënt leveren dat voorgegetrainde modellen niet kunnen bieden: nauwkeurige, domeinspecifieke en consistent gelabelde trainingsdata op grote schaal. Voor NER- en entiteitsextractieprojecten bieden wij het volgende:
- domeindeskundige annotatoren — inclusief gespecialiseerde teams voor medische, juridische, financiële en klinische NER, waar generieke etiketten tekortschieten.
- Relatie- en ontkenningslabeling, niet alleen platte entiteitstags, zodat je model betekenis en context leert.
- HIPAA, GDPR en SOC 2-afgestemde workflows, met anonimisering van gevoelige gegevens zoals PHI en PII.
- Meertraps QA Ontwikkeld door procesexperts om elke dataset aan uw kwaliteitsnorm te laten voldoen.
- Flexibele schaalgebruikmakend van een wereldwijd personeelsbestand en grote eigen dataopslagplaatsen.
Of u nu een aangepaste NER-dataset, klinische anonimisering of end-to-end named entity recognition-annotatie nodig hebt , onze teams kunnen het volgens uw schema bouwen.
Klaar om betrouwbare NER-trainingsdata te creëren? Neem contact op met Shaip om uw project te bespreken en een aangepaste NER-dataset voor uw AI/ML-modellen te ontvangen.
NER FAQ: vragen die teams stellen voordat ze aan een project beginnen
Dit zijn de vragen die het vaakst opduiken wanneer teams de stap zetten van "wat is NER" naar het daadwerkelijk definiëren, budgetteren en inkopen van een NER-project.
Hoeveel gelabelde data heb ik nodig om een aangepast NER-model te trainen?
Plan voor een paar duizend geannoteerde voorbeelden per entiteitstype als praktisch uitgangspunt — in de praktijk worden aangepaste NER-modellen vaak getraind op een paar duizend voorbeelden. Trainen vanaf nul vereist veel meer, dus de meeste teams verfijnen liever een voorgegetraind model. De kwaliteit en consistentie van de labels zijn belangrijker dan de hoeveelheid; ruis in de data beperkt de nauwkeurigheid snel.
Moet ik mijn NER-trainingsdataset zelf ontwikkelen of de annotatie uitbesteden?
Besteed taken uit wanneer u behoefte heeft aan volume, snelheid, domeinexpertise of compliance waarvoor u intern niet voldoende personeel kunt vinden; ontwikkel het alleen intern wanneer uw schema eenvoudig, stabiel en klein is. De meeste teams onderschatten annotatie — richtlijnen, labeling en kwaliteitscontrole nemen het grootste deel van een NER-project in beslag. Een gespecialiseerde partner zoals Shaip neemt die last van u over, zodat uw engineers zich kunnen concentreren op modelleren in plaats van labelen.
Waarom mist mijn NER-model steeds domeinspecifieke entiteiten?
Omdat algemene modellen getraind zijn op nieuws- en webteksten, herkennen ze zelden gespecialiseerde termen zoals namen van geneesmiddelen, juridische bepalingen of financiële instrumenten. De oplossing is het verfijnen van het model met geannoteerde, domeinspecifieke data die deze entiteiten in een realistische context bevat. Inconsistente labelrichtlijnen zijn een andere veelvoorkomende oorzaak, dus zorg ervoor dat uw annotatieregels duidelijk zijn voordat u het model opschaalt.
Wat zijn de kosten voor het bouwen van een aangepaste NER-dataset?
De kosten zijn afhankelijk van de complexiteit van de entiteit, het annotatievolume, de vereiste domeinexpertise en de nalevingsvereisten. Klinische of juridische etikettering kost meer dan algemene tekst, omdat hiervoor deskundige annotatoren en strengere kwaliteitscontroles nodig zijn. De prijs wordt doorgaans per pagina, per document of per geannoteerde eenheid berekend. Shaip stemt elk NER-project af op uw schema en kwaliteitsnormen en levert een offerte op maat.
Waar kan ik hoogwaardige NER- of klinische NER-trainingsdata verkrijgen?
U kunt op drie manieren trainingsdata voor Named Entity Recognition (NER) verkrijgen: een kant-en-klare dataset in licentie nemen, een eigen dataset verzamelen en annoteren, of een bestaand corpus uitbreiden. Voor domeinspecifiek of gereguleerd werk – medisch, juridisch, financieel – is een managed annotation provider de meest betrouwbare optie. Shaip levert aangepaste NER-datasets, klinische NER en HIPAA-conforme anonimisering, volledig afgestemd op uw specifieke behoeften.
Wat is het verschil tussen NER, entiteitsextractie en entiteitskoppeling?
NER detecteert en classificeert entiteiten op basis van type (persoon, organisatie, locatie). Entiteitsextractie wordt vaak door elkaar gebruikt met NER, soms in bredere zin voor het extraheren van gestructureerde velden uit tekst. Entiteitskoppeling gaat een stap verder door een herkende entiteit te koppelen aan een uniek record in een kennisbank — waarmee wordt bepaald welke "Apple" of welke "Jordan" bedoeld wordt.
Conclusie
Named Entity Recognition (NER) is een krachtige NLP-techniek die sleutelentiteiten in tekst identificeert en classificeert, waardoor machines menselijke taal effectiever kunnen begrijpen en verwerken. Van het verbeteren van zoekmachines en chatbots tot het aansturen van klantenondersteuning en financiële analyses, NER heeft uiteenlopende toepassingen in verschillende sectoren. Hoewel er nog uitdagingen zijn op gebieden als het oplossen van ambiguïteiten en het verwerken van ongestructureerde data, beloven voortdurende ontwikkelingen, met name op het gebied van deep learning, de mogelijkheden van NER verder te verfijnen en de impact ervan in de toekomst uit te breiden.




