Houdingsschatting is de computervisietaak waarbij lichaamskenmerken – gewrichten en gelaatstrekken – worden gelokaliseerd en verbonden tot een skelet dat beschrijft hoe een persoon of object gepositioneerd en bewogen is. Voor fysieke AI vormen deze skeletbewegingsgegevens de brug die waargenomen menselijke bewegingen omzet in acties die een robot kan imiteren en uitvoeren.
Die laatste zin laat zien waar de aandacht van de industrie zich stilletjes op heeft gericht. Tien jaar lang werd houdingsschatting gebruikt in fitness-apps en sportuitzendingen – nuttig, maar beperkt. Nu zijn diezelfde sleutelpunten en skeletten een essentieel trainingssignaal geworden voor humanoïde robots, autonome systemen en visie-taal-actiemodellen. Wanneer een robot leert schenken, stapelen, sorteren of iets aan een persoon aangeven, heeft hij veel geleerd door eerst te kijken hoe mensen dat deden – en dat kijken is houdingsdata.
Wat pose-schatting daadwerkelijk vastlegt
In essentie detecteert pose-schatting een reeks sleutelpunten — anatomische oriëntatiepunten zoals schouders, ellebogen, polsen, heupen, knieën en enkels, plus gezichtspunten zoals ogen, neus en oren — en verbindt deze tot een skelet dat houding en beweging representeert. Door dat skelet over verschillende frames te volgen, krijg je een compacte, machineleesbare beschrijving van hoe een lichaam zich in de tijd beweegt.
Het vakgebied is onderverdeeld langs een paar bekende lijnen. Menselijke houdingsschatting richt zich op mensen; dezelfde technieken kunnen worden toegepast op dieren en objecten. Detectie kan 2D zijn (het lokaliseren van sleutelpunten als x, y pixelcoördinaten) of 3D (het toevoegen van diepte, z, voor een echt ruimtelijk skelet). Er zijn nog meer keuzes op modelniveau – bijvoorbeeld detectie van één of meerdere personen – maar dat zijn architectuurbeslissingen voor het modelteam, geen eigenschappen van de trainingsdata. Of een houdingsmodel succesvol is, hangt niet af van de detectiestrategie, maar van de nauwkeurigheid, consistentie en dekking van de sleutelpunten die het model heeft geleerd. Dat is een dataprobleem, en dat is het aspect dat teams onderschatten.
Waarom posedata de ontbrekende schakel is voor fysieke AI
Een fysiek AI- systeem moet een cyclus voltooien die een chatbot nooit doorloopt: de wereld waarnemen, een beslissing nemen en er vervolgens fysiek naar handelen . De waarneming is volwassen geworden – robots kunnen zien. De uitdaging is om wat ze zien te vertalen naar gecoördineerde, fysiek correcte acties, en houdings- en bewegingsgegevens vormen daarvoor de basis.
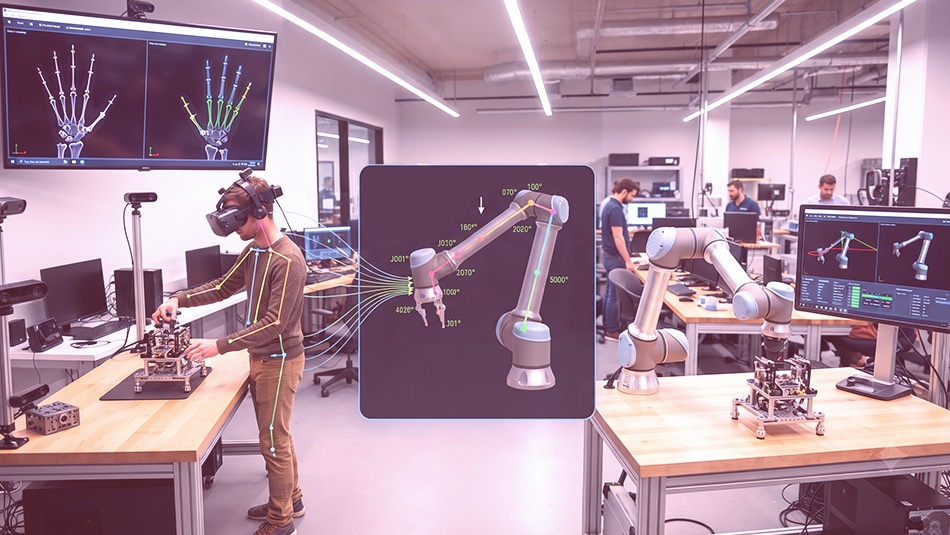
Laten we eens kijken hoe moderne robotleerprocessen vaardigheden verwerven. Echte robotdemonstraties, vastgelegd via teleoperatie, zijn weliswaar nauwkeurig, maar het verzamelen ervan is traag en kostbaar. Daarom trainen teams steeds vaker met iets dat veel overvloediger beschikbaar is: video's van mensen die taken uitvoeren. Recent robotica-onderzoek heeft aangetoond dat beleidsregels die zijn getraind op grootschalige, egocentrische video's van mensen beter generaliseren dan beleidsregels die alleen op robotdata zijn getraind. Dit komt doordat video's van mensen de diversiteit, de natuurkundige principes en de taakstructuur bevatten die in laboratoria verzamelde robotdata op grote schaal niet kunnen evenaren.
Maar onbewerkte videobeelden van mensen zijn niet direct bruikbaar voor een robot. Een robot heeft geen lichaam dat identiek is aan dat van jou; hij heeft zijn eigen gewrichten, eindeffectoren en bewegingsvrijheid. Houdingsschatting is de vertaallaag. Door een menselijke demonstratie te reduceren tot een gestructureerd skelet – en, cruciaal, een handskelet – kan die beweging worden omgezet in de kinematica van een robot en in actietrajecten waarop een model kan trainen. Dit is precies de input waar vision-language-action (VLA) modellen naar snakken.
Houdingsgegevens komen in de gehele fysieke AI-stack in drie terugkerende vormen voor: de houding van de operator vastgelegd tijdens teleoperatie, de houding van de werknemer voor collaboratieve robots die de ruimte veilig met mensen moeten delen, en de houding van een menselijke demonstratie, verkregen uit egocentrische video's vanuit een eerstepersoonsperspectief en omgezet in robotacties. In elk geval bepaalt de kwaliteit van het skelet de maximale kwaliteit van de bewegingen die de robot kan leren.
Van bewegingsregistratie tot robotbeweging
De brug tussen menselijke beweging en robotbeweging loopt vaak via parametrische 3D-lichaamsmodelleringstechnieken. Hierbij wordt een volledig lichaam – inclusief handen – aangepast aan geschatte sleutelpunten, waardoor fysiek coherente beweging wordt gegenereerd op basis van gewone videobeelden. Dit is in feite markerloze bewegingsregistratie. Voor robotica wordt het aangepaste lichaam een bron van zuivere actietrajecten: reiken, grijpen, tillen, plaatsen, loslaten, waarbij elke fase gesegmenteerd en getimed is. Hoe beter de onderliggende pose-annotatie, hoe zuiverder het aangepaste traject.
2D- versus 3D-pose: welke heeft jouw robot nu echt nodig?
Dit is de vraag die robotica-teams het vaakst stellen, en het eerlijke antwoord is: het hangt ervan af wat de robot met de pose moet doen .
2D-houdingsschatting geeft je sleutelpunten in het beeldvlak. Dat is voldoende voor vormcontrole, gebarenherkenning en activiteitsclassificatie, en het is goedkoper om vast te leggen en sneller te annoteren. Maar het kan je niet vertellen hoe ver de hand van de mok verwijderd is, of de werkelijke hoek van een gewricht in de ruimte.
Bij 3D-pose-schatting wordt de diepte-as toegevoegd, waardoor een driedimensionaal gepositioneerd metrisch skelet ontstaat. Voor manipulatietaken – grijpen, plaatsen, taken waarbij veel contact is – is dit meestal onmisbaar, omdat grijppunten en gewrichtshoeken metrische nauwkeurigheid vereisen op het moment dat een robot iets moet aanraken. De driedimensionale pose wordt doorgaans hersteld met stereo- of dieptecamera's, LiDAR, multicamerasystemen of 2D-naar-3D-lifting, en dit brengt hogere kosten met zich mee, zowel voor de opname als voor de annotatie.
De regel die we onze klanten meegeven: als uw systeem alleen beweging hoeft te begrijpen , is 2D wellicht voldoende; als het beweging in de fysieke wereld moet reproduceren , plan dan voor 3D — en ontwerp uw sensorconfiguratie en annotatieschema daar vanaf dag één op, niet pas na de eerste mislukte poging.
Handhouding en behendigheid
Als de lichaamshouding een robot naar het object brengt, zorgt de handhouding ervoor dat hij daar succesvol is. Behendige manipulatie is afhankelijk van nauwkeurige tracking van vingergewrichten, contactpunten en grijpconfiguratie – vaak twintig of meer sleutelpunten per hand. Dit is waar veel fysieke AI momenteel vastloopt en waar de annotatiestandaard het hoogst is. Gecombineerde video- en handhoudingsgegevens zijn zeer effectief gebleken voor het aanleren van manipulatie; het betrouwbaar en op grote schaal produceren van dergelijke gegevens is echter een specialistische discipline.
Waar Pose Data breekt
Pose-modellen falen op voorspelbare manieren, en bijna al deze fouten zijn terug te voeren op de trainingsdata in plaats van op de architectuur:
- Occlusie. Ledematen gaan schuil achter torso's, handen verdwijnen achter objecten, onderwerpen verlaten het beeld. Of je verborgen sleutelpunten eerlijk aangeeft of ze gokt, bepaalt de betrouwbaarheid van het model.
- Meerdere personen overlappen elkaar. Wanneer personen elkaar tegenkomen, worden belangrijke gegevens verwisseld of samengevoegd, waardoor nauwkeurige identiteitsregistratie van groot belang is.
- Variatie in gezichtspunt, belichting en kleding. Een model dat alleen is getraind op schone, van voren gerichte, goed verlichte beelden, stort in de echte wereld in elkaar.
- Diepte-ambiguïteit. Bij 3D-poses is het afleiden van diepte uit beperkte aanzichten inherent moeilijk en vereist consistente annotatie om te voorkomen dat er onjuiste geometrie wordt aangeleerd.
- Dynamische beweging. Snelle bewegingen veroorzaken onscherpte en verschuivingen tussen frames; belangrijke punten moeten stabiel blijven in de tijd, niet alleen correct zijn in afzonderlijke frames.
- Anatomische consistentie. Een markering op de pols in het ene frame en halverwege de onderarm in het volgende frame verstoort ongemerkt de dataset.
De rode draad: een posemodel erft elke inconsistentie in zijn sleutelpunten, en in fysieke AI worden die inconsistenties verkeerde – soms zelfs onveilige – bewegingen. De discipline van de annotatiepipeline is net zo belangrijk als de hoeveelheid data.
Een kijkje in een realistische pose-pipeline: Shaips keypointproject met 150,000 frames.
Voor een klant in de computervisie-sector annoteerde Shaip 150,000 frames aan beeld- en videomateriaal met behulp van een aangepast schema van 36 sleutelpunten – gezichtslandmarkpunten plus een volledig lichaamsskelet – dat is ontworpen om zowel pose-schatting als gezichtsbewegingsanalyse in één keer te ondersteunen. Het werk omvatte diverse poses, hoeken, belichting en kleding, waarbij occlusie op een eerlijke manier werd behandeld (verborgen landmarkpunten werden gemarkeerd, nooit gegokt) en elk frame een gestructureerde kwaliteitscontrole onderging volgens een gekalibreerde nauwkeurigheidsbenchmark. Het resultaat was een productiegereed pipeline voor de pose-, bewegings-, fitness- en bewegingsmodellen in de gezondheidszorg van de klant. Meer details vindt u in onze casestudy over annotatie van sleutelpunten van het menselijk lichaam.
De conclusie: dat project heeft weliswaar een model voor menselijke bewegingen getraind , maar de discipline die daarvoor nodig was – een gedetailleerd, op maat gemaakt schema, eerlijke behandeling van occlusie en diversiteit in houdingen op grote schaal – is dezelfde discipline die vereist is voor beleid met betrekking tot humanoïde robots of collaboratieve robots. De toepassing verandert, maar de standaard voor de data niet.
Toepassingsvoorbeelden van positiebepaling: praktijkvoorbeelden
Houdings- en bewegingsgegevens worden tegenwoordig gebruikt om systemen te trainen die veel verder gaan dan robotica, en elk vakgebied stelt zijn eigen kernpuntenschema en nauwkeurigheidsnorm vast. Voor teams die zich bezighouden met fysieke AI is het nuttige inzicht dat dit overlappende bronnen zijn van dezelfde waarde: zeer nauwkeurige gegevens over menselijke bewegingen die kunnen worden ingezet voor belichaamde intelligentie.
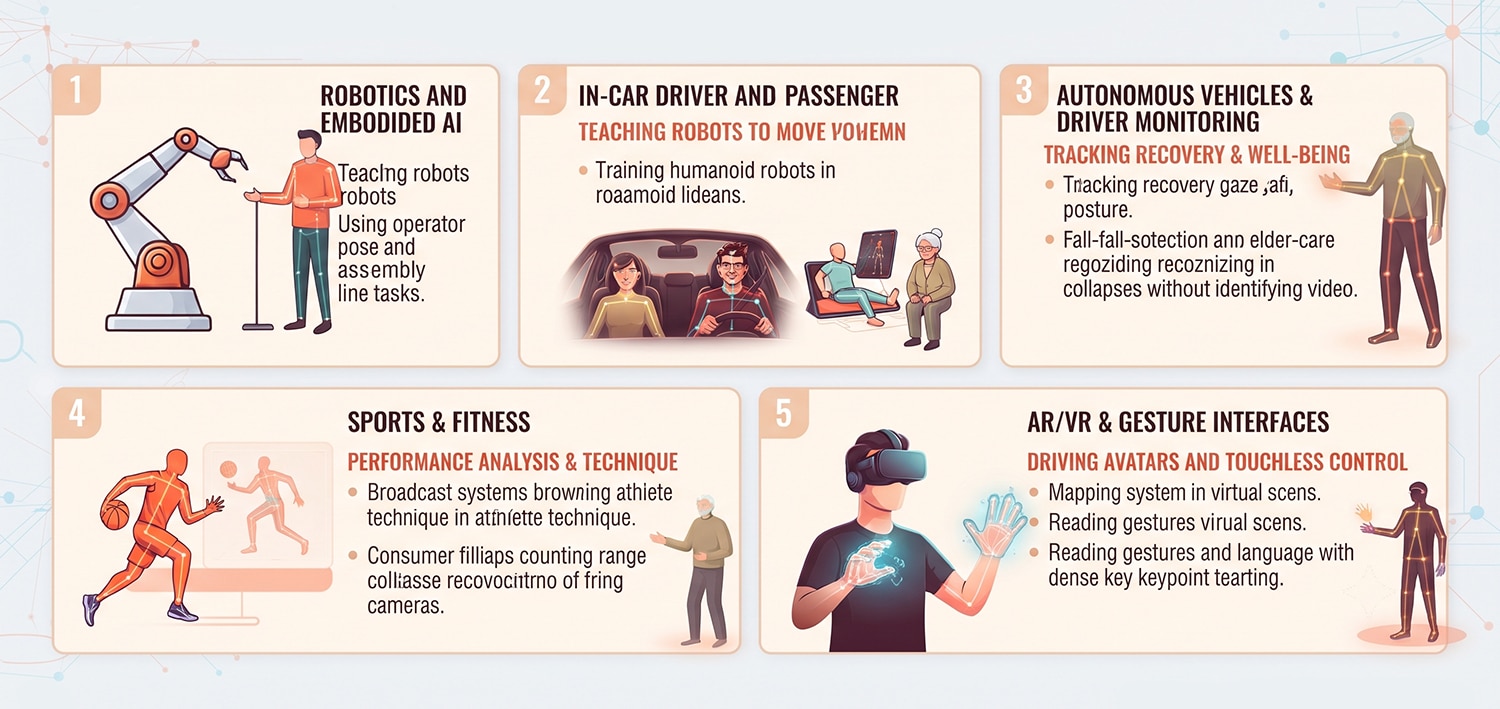
Robotica en belichaamde AI — de belangrijkste grensverleggende technologie. Houdingsgegevens leren robots bewegen door te leren van menselijke demonstraties. Een humanoïde robot in een magazijn die leert kratten op te tillen en op een transportband te plaatsen, wordt deels getraind met behulp van video-opnamen van mensen die dezelfde taak uitvoeren, waarbij de houding van de operator uit teleoperatiesessies de precieze bewegingspatronen levert. Op assemblagelijnen gebruiken collaboratieve robots de realtime houding van werknemers om een veilige afstand te bewaren en onderdelen zonder botsingen door te geven — dit soort taken, zoals het hanteren van kratten en andere werkzaamheden aan de productielijn, worden momenteel getest in logistieke en automobielfabrieken.
Autonome voertuigen en bestuurdersmonitoring. In de cabine volgt een systeem voor houdingsschatting de hoofdpositie, blikrichting en lichaamshouding van de bestuurder om slaperigheid of afleiding te detecteren. Bestuurdersmonitoringsystemen die in nieuwe voertuigen worden ingebouwd om te voldoen aan de Euro NCAP-veiligheidseisen van 2026, zijn juist afhankelijk van deze gezichtskenmerken en belangrijke informatie.
Gezondheidszorg en revalidatie. Houdingsschatting meet hoe een lichaam daadwerkelijk beweegt, wat clinici gebruiken om het herstel te volgen. Een fysiotherapie-app kan een patiënt zien oefenen via een telefooncamera, de bewegingsamplitude meten en een verkeerde houding signaleren; een valdetectiesysteem in een ouderenzorginstelling kan een val herkennen aan de hand van de beweging van het skelet alleen, zonder identificerende video op te slaan.
Sport en fitness. Dankzij skeletanalyse worden gewone video's omgezet in prestatiegegevens. Televisie-uitzendingen projecteren realtime skeletten op atleten om hun techniek te analyseren, terwijl fitness-apps voor consumenten herhalingen tellen en de houding corrigeren met niets meer dan een telefooncamera.
AR/VR en gebareninterfaces. Lichaams- en handposities sturen avatars aan en maken bediening zonder aanraking mogelijk. Een headset die je handen in een virtuele scène projecteert, of een interface die gebaren en gebarentaal leest, is afhankelijk van nauwkeurige tracking van handpunten, zelfs bij sterke zelfocclusie.
Een partner kiezen voor houdings- en sleutelpuntgegevens
Als u evalueert wie uw pose-data moet genereren, zijn de vragen die leveranciers van elkaar onderscheiden operationeel, niet cosmetisch: