Je belt om 9 uur je bank om een transactie te betwisten. Een stem neemt op, begrijpt het probleem meteen, zoekt de transactie op, bevestigt je identiteit en lost het op — geen wachtmuziek, geen doorverbinden, geen "druk op 4 om terug te keren naar het hoofdmenu". Die interactie voelt als een triomf van AI.

Dat klopt. Maar niet op de manier waarop de meeste mensen denken. Het model is nu grotendeels gemeengoed. Wat die oproep succesvol maakte, waren duizenden uren aan opgenomen spraak van mensen die praten zoals jij, gelabeld door annotatoren die het eens waren over wat "een aanklacht betwisten" betekent, gescreend op de accenten en formuleringen die het systeem daadwerkelijk zal horen, en beheerd zodat niemands stem zonder toestemming in een trainingsset terechtkwam.
Dat is het ware verhaal van conversationele AI in 2026. De markt stevent af op $ 82.46 miljard met een samengestelde jaarlijkse groei van ongeveer 21% , 78% van de organisaties gebruikt AI nu in ten minste één bedrijfsfunctie en 75% is van plan om grote taalmodellen in te zetten voor klantenservice. De technologie is gevestigd. Het onderscheidende element is verschoven naar de data. Zo past het geheel in elkaar.
Wat conversationele AI nu eigenlijk is
Conversational AI is de verzameling systemen — chatbots, virtuele agenten, spraakassistenten — die spraakherkenning, natuurlijk taalbegrip en spraakgeneratie combineren om een natuurlijk, heen-en-weer gesprek te voeren, en die steeds beter worden naarmate ze vaker worden gebruikt.
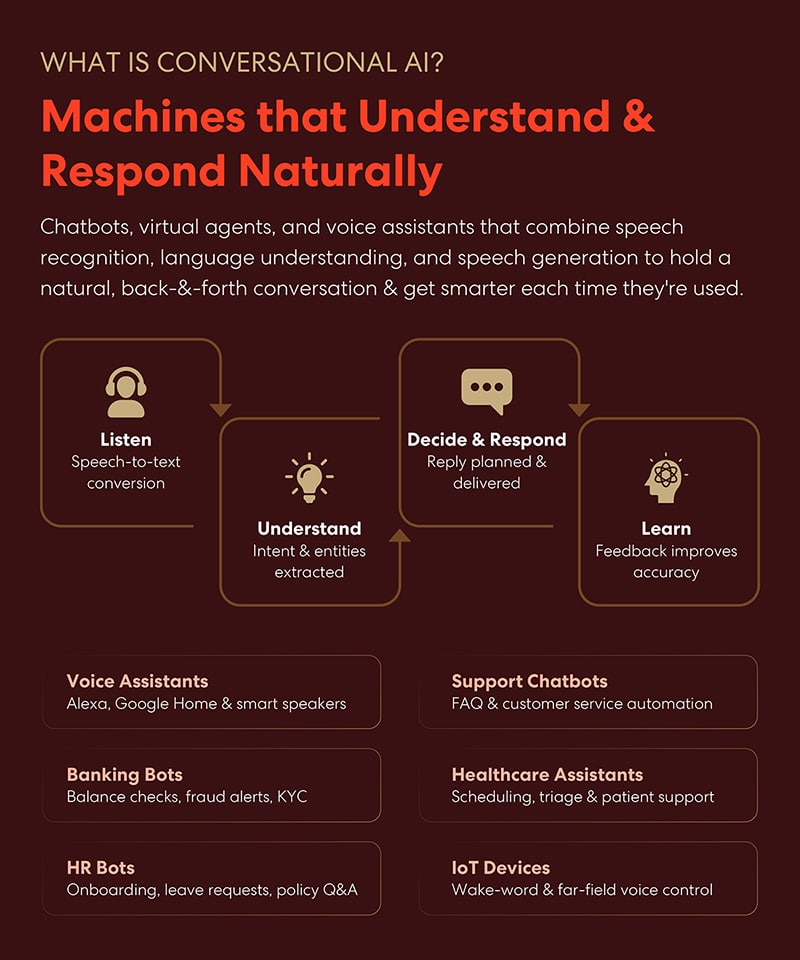
Onder de verschillende varianten doorlopen ze allemaal dezelfde vierstappenlus.
- Het systeem luistertHet omzetten van spraak naar tekst.
- It begrijptwaarbij de intentie en entiteiten worden geëxtraheerd — wat de gebruiker wil en de specifieke details die aan die wens zijn verbonden.
- It beslist en reageerteen antwoord voorbereiden en dat vervolgens uitbrengen.
- En leertwaarbij feedbacksignalen worden gebruikt om de nauwkeurigheid bij de volgende beurt en de volgende gebruiker te verbeteren.
Luisteren → begrijpen → beslissen → leren. Elk product hieronder is een ander domein dat is opgebouwd rond diezelfde cyclus.
- Stem assistenten Net zoals Alexa en Google Home via slimme luidsprekers open vragen in huis kunnen beantwoorden.
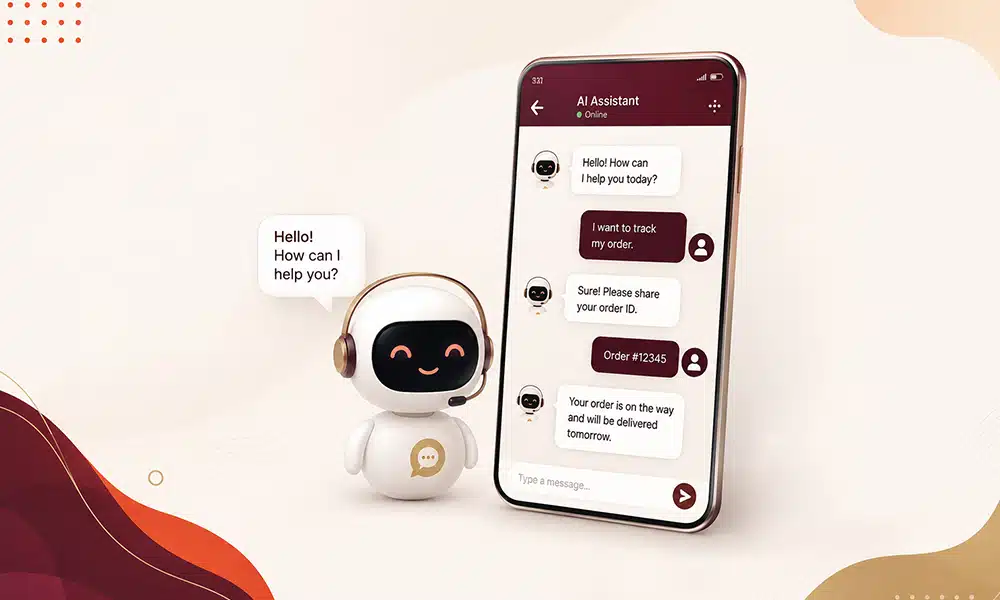
- Ondersteuning van chatbots Automatiseer de afhandeling van veelgestelde vragen en de triage van klantenservicevragen.
- Bankbots Saldocontroles, fraudewaarschuwingen en KYC-verificatie uitvoeren.
- Zorgassistenten Het plannen van afspraken, het beoordelen van symptomen en het bieden van ondersteuning aan patiënten.
- HR-bots Vragen over onboarding, verlofaanvragen en beleidskwesties.
- En IoT-apparaten Ze vertrouwen op wake-word-detectie en spraakbesturing op afstand, waarbij de microfoon zich aan de andere kant van de kamer bevindt en de gebruiker niet naar een scherm kijkt.
Dezelfde pipeline, maar radicaal verschillende faalomstandigheden. Een chatbot in de detailhandel die de intentie verkeerd interpreteert, kost een conversie. Een triage-assistent in de gezondheidszorg die de intentie verkeerd interpreteert, is een incident dat de patiëntveiligheid in gevaar brengt. Dat verschil zit hem in de data, niet in de architectuur.
Hoe onbewerkte spraak trainingsdata wordt
Het proces om van een opname naar een dataset te komen die geschikt is voor een model, bestaat uit twee afzonderlijke stappen: eerst de keuze van de manier waarop de spraak wordt verzameld, en vervolgens het labelen ervan zodat een model ervan kan leren. Teams die dit als één stap beschouwen, eindigen vaak met een grote dataset die de verkeerde dingen leert.
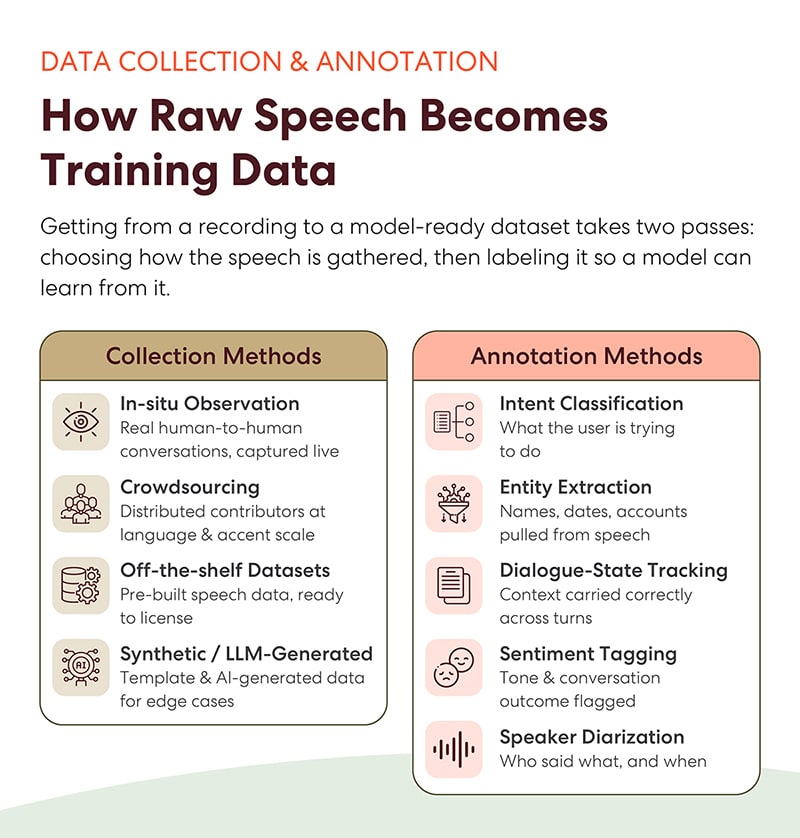
Wat de inzameling betreft, dekken vier methoden de meeste behoeften.
- Observatie ter plaatse Legt echte gesprekken tussen mensen live vast — het meest betrouwbare signaal dat beschikbaar is, en het moeilijkst op grote schaal te verkrijgen.
- crowdsourcing Het systeem verspreidt opnames onder medewerkers die geselecteerd zijn op basis van taal en accent, waardoor de berichtgeving doelbewust in plaats van per ongeluk tot stand komt.
- Kant-en-klare datasets Lever vooraf samengestelde en goedgekeurde spraakdata die direct onder licentie beschikbaar zijn, waardoor de doorlooptijd met maanden wordt verkort wanneer het domein redelijk overeenkomt.
- En synthetisch of LLM-gegenereerd Data vult specifieke hiaten op: op sjablonen gebaseerde en door AI gegenereerde uitingen voor uitzonderlijke gevallen die te zeldzaam zijn om op te wachten.
Aan de annotatiekant zetten vijf labellagen audio om in supervisie.
- Intentie classificatie tags die aangeven wat de gebruiker probeert te doen.
- Entiteit extractie Haalt de namen, data en rekeningnummers uit de spraak.
- Dialoogstatus volgen Het systeem behoudt de context tussen de beurten, zodat het weet dat "de tweede" verwijst naar iets dat vier beurten geleden is genoemd.
- Sentiment tagging Geeft de toon en de uitkomst van het gesprek aan.
- En spreker diarisatie Hiermee wordt vastgesteld wie wat heeft gezegd en wanneer — iets wat niet onderhandelbaar is voor elke opname met meerdere deelnemers, oftewel voor de meeste echte gespreksgegevens.
Verzamelen → transcriberen → intenties en entiteiten labelen → status bijhouden → dagboek maken → valideren. Sla een laag over en je krijgt een model dat vloeiend transcribeert maar niets begrijpt.
Wat "goede data" nu eigenlijk meet.
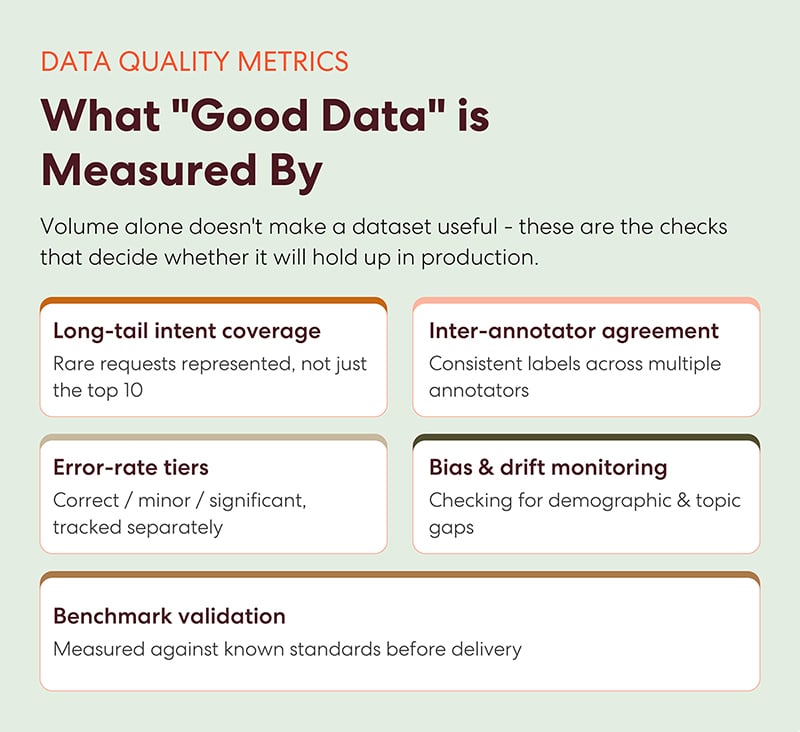
Alleen de omvang van een dataset maakt hem nog niet bruikbaar. Vijf criteria bepalen of de dataset in een productieomgeving standhoudt, en het is de moeite waard om de leverancier hier rechtstreeks naar te vragen.
- Intentiedekking op de lange termijn De vraag is of zeldzame verzoeken vertegenwoordigd zijn, en niet alleen de top tien. De meeste datasets worden gedomineerd door de handvol intenties die gebruikers constant gebruiken, en de meeste productiefouten doen zich voor in de staart van die intenties.
- Overeenkomst tussen annotatoren Deze maatstaf controleert of meerdere annotatoren dezelfde uitspraak op dezelfde manier labelen; een lage mate van overeenstemming betekent dat uw labels verwarring weergeven in plaats van de werkelijke situatie.
- Foutpercentagecategorieën Maak onderscheid tussen correcte, kleine en significante fouten en houd ze onafhankelijk van elkaar bij, want een foutenpercentage van 3% dat bestaat uit catastrofale verkeerde classificaties is niet hetzelfde als een percentage van 3% dat bestaat uit triviale fouten.
- Monitoring van bias en drift Het systeem controleert op lacunes in demografie en onderwerpen, en houdt deze in de gaten naarmate taal en gebruikersgedrag veranderen.
- En benchmarkvalidatie De dataset wordt vóór levering getoetst aan bekende standaarden, zodat de kwaliteit gewaarborgd is voordat deze een probleem vormt.
Deze vijf punten maken het verschil tussen een dataset waarop je direct aan de slag kunt en een dataset die je helemaal opnieuw moet verwerken.
Vertrouwen is ingebouwd in de datalaag, niet achteraf toegevoegd.
Spraakdata bevat iemands stem en woorden – twee van de meest kenmerkende eigenschappen van een persoon. Governance moet vanaf het moment van dataverzameling worden ingebouwd, omdat het niet mogelijk is om achteraf toestemming toe te voegen aan een opname waarop al getraind is.
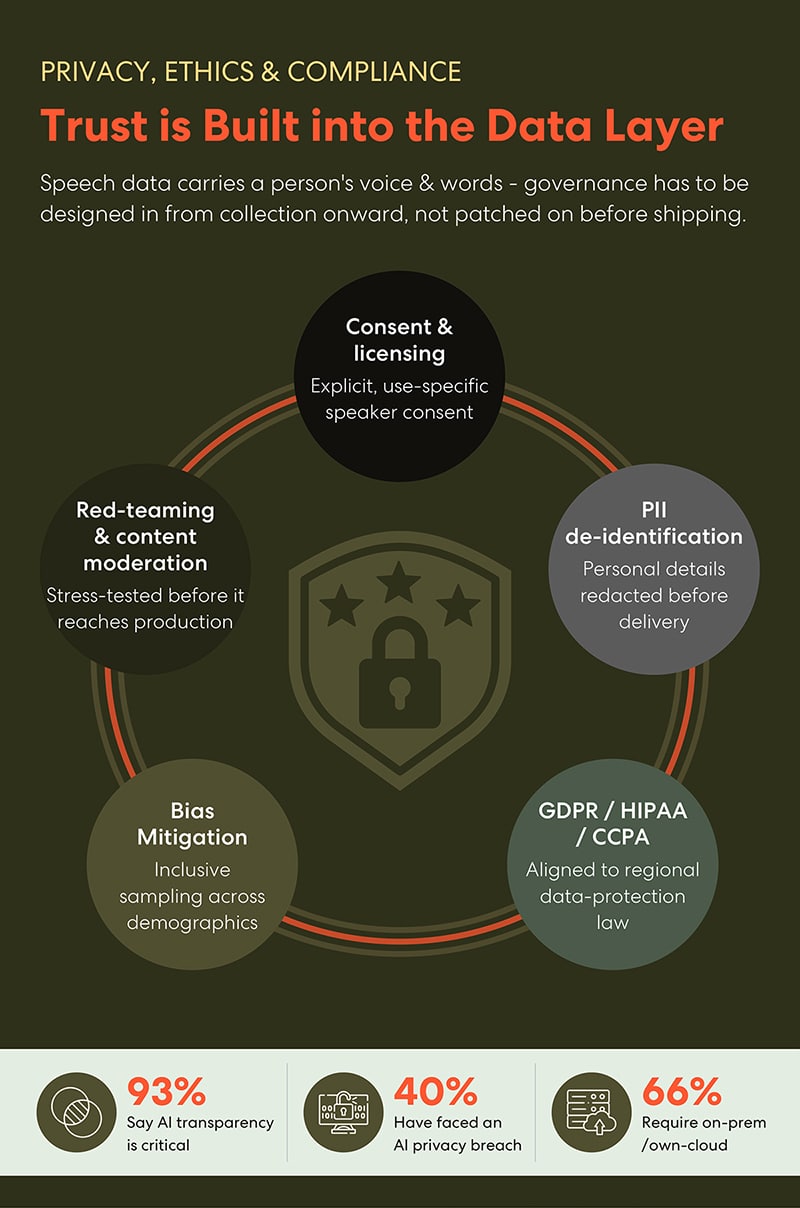
Vijf beheersmaatregelen definiëren een verdedigbare datalaag.
- Toestemming en licentieverlening Dit betekent expliciete, gebruiksspecifieke toestemming van de spreker – geen algemene clausule in de gebruiksvoorwaarden.
- PII-anonimisering Persoonsgegevens worden vóór de levering verwijderd, niet na een incident.
- Afstemming van GDPR, HIPAA en CCPA brengt de pipeline in kaart en koppelt deze aan de regionale wetgeving inzake gegevensbescherming die daadwerkelijk van toepassing is op de implementatie.
- Vermindering van bias Het integreren van inclusieve steekproeven over verschillende demografische groepen in het verzamelplan, waar het niets kost, in plaats van in de herstelprocedure, waar het alles kost.
- En red-teaming en contentmoderatie Het systeem wordt aan stresstests onderworpen voordat het in productie wordt genomen.
De markt heeft dit al ingeprijsd. 93% van de organisaties zegt dat transparantie over AI cruciaal is, 40% heeft al te maken gehad met een privacyschending door AI en 66% vereist nu een implementatie op locatie of in de eigen cloud. Kopers vragen zich af waar de data vandaan komen – en steeds vaker willen ze het antwoord in een contract.
Waar conversationele AI opduikt
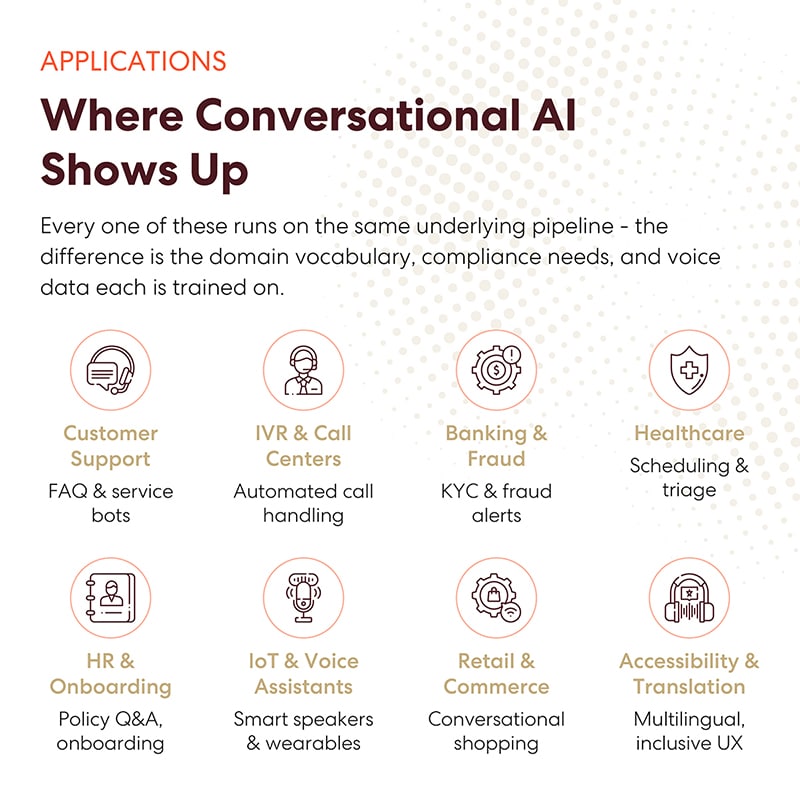
Acht toepassingsgebieden zijn verantwoordelijk voor het grootste deel van de implementatie binnen bedrijven.
- Klantenservice Voert FAQ- en servicebots uit.
- IVR-systemen en callcenters automatiseren de afhandeling en routering van telefoongesprekken.
- Bankwezen en fraude Omvat KYC-verificatie en fraudewaarschuwingen.
- Gezondheidszorg Verzorgt de planning en de triage.
- HR en onboarding Beheert de vragen en antwoorden over beleid en de workflow voor nieuwe medewerkers.
- IoT en spraakassistenten Voorzie slimme luidsprekers en wearables van stroom.
- Detailhandel en commercie Maakt conversatiegericht winkelen mogelijk.
- En toegankelijkheid en vertaling Biedt een meertalige, inclusieve gebruikerservaring aan mensen die door de standaardinterface worden buitengesloten.
Al deze systemen draaien op dezelfde onderliggende pipeline. Het verschil zit hem in de vakspecifieke woordenschat, de compliance-eisen en de spraakdata waarop ze getraind zijn. Die laatste variabele is vaak het aspect waarin teams te weinig investeren en dat bepaalt of de implementatie buiten de demo wel of niet werkt.
Betere conversationele AI begint met betere data.
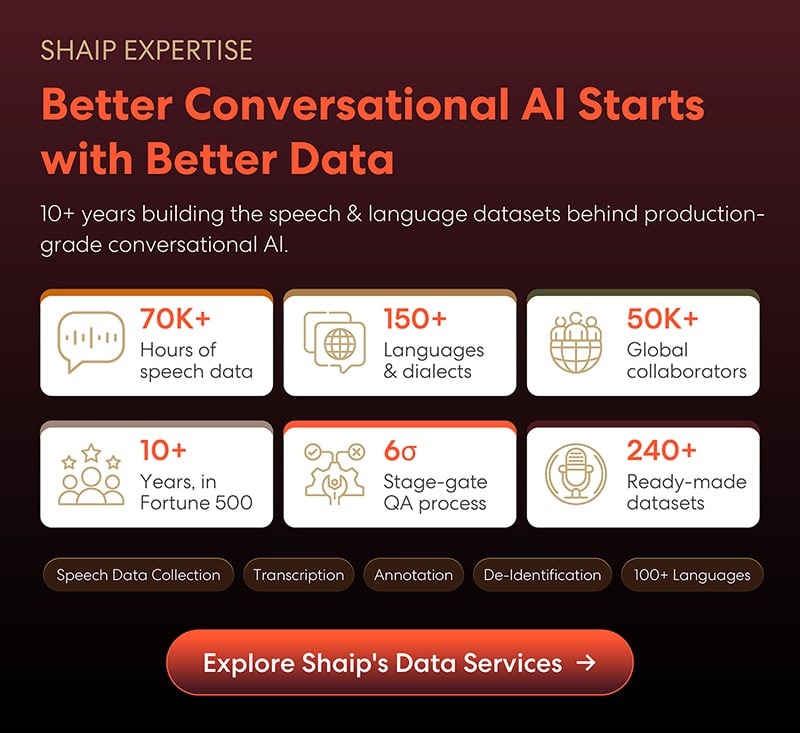
Het overbruggen van de kloof tussen een werkend prototype en een productierijpe assistent is een data-operationeel probleem, en daar heeft Shaip zich al meer dan tien jaar mee beziggehouden:
- 70K+ uur van spraakgegevens,
- 150+ talen en dialecten,
- Meer dan 50 wereldwijde medewerkers,
- 10 + jaar het ondersteunen van AI-teams van Fortune 500-bedrijven,
- a six-sigma stage-gate QA-proces,
- Meer dan 240 kant-en-klare datasets Direct leverbaar wanneer tijdgebrek het niet toelaat om alles vanaf nul op te bouwen.
Bij het verzamelen van spraakgegevens, transcriptie, annotatie en anonimisering is het doel hetzelfde: trainingsgegevens die de mensen weerspiegelen met wie uw product daadwerkelijk zal communiceren, met een bewijs van toestemming en kwaliteitsstatistieken.
The Bottom Line
Conversational AI is niet langer een puur technologische kwestie. De mechanismen zijn goed begrepen, de modellen zijn breed beschikbaar en de toepassingen zijn opgenomen in de budgetten van elke sector. Wat echt lastig blijft, is de datalaag: dekking van de longtail, overeenstemming over labels, demografische balans, toestemming en anonimisering.
Daar zit hem ook het voordeel. Twee teams die hetzelfde model gebruiken, leveren producten van zeer verschillende kwaliteit af, en dat verschil is terug te voeren op de data waarop hun systemen getraind zijn. Als je conversationele AI ontwikkelt, gaan de belangrijkste beslissingen die je neemt niet over de architectuur. Ze gaan over wiens stemmen er in je dataset zitten, hoe goed ze gelabeld zijn en of je het recht had om ze te gebruiken.