Datagestuurde besluitvorming is vandaag de dag de mantra voor succes en uitmuntendheid van ondernemingen. Van fintech en productie tot retail en supply chain: elke sector maakt gebruik van de big data-golf en realiseert op statistieken gebaseerde besluitvorming met zijn geavanceerde analysemodellen en algoritmen. In de gezondheidszorg wordt dit des te lonender en levensreddender, omdat het de basis vormt voor innovatie en wetenschappelijke vooruitgang.
Met zo'n enorme reikwijdte komen ook uitdagingen. Naarmate de vraag naar zorggegevens voor uiteenlopende doeleinden toeneemt, stijgt ook de kans op datalekken en misbruik van gevoelige informatie. Een rapport uit 2023 onthult dat meer dan 133 miljoen medische dossiers en gegevens zijn gestolen, waarmee een nieuw record is gevestigd voor datalekken in de gezondheidszorg.
De invoering van de HIPAA-regelgeving was een geruststellende stap in de optimalisatie van de privacy van zorggegevens , die eigenhandig en significant het aantal datalekken met 48% heeft teruggebracht . Rapporten tonen ook aan dat 61% van alle datalekken te wijten is aan nalatigheid van werknemers en professionals in deze sector.
Om dergelijke aanvallen en de massale blootstelling van kwetsbaarheden verder te beperken, is er synthetische patiëntdata beschikbaar . Zoals het gezegde luidt: "Moderne problemen vereisen moderne oplossingen." De opkomst van synthetische data in de gezondheidszorg stelt zorgprofessionals in staat om patiëntgegevens te versterken en AI-modellen te gebruiken om hen te helpen bij het genereren van actuele data.
In dit artikel gaan we dieper in op wat synthetische datageneratie precies inhoudt en de talloze aspecten ervan.
Synthetische patiëntgegevens: wat is het?
Synthese is het proces waarbij iets nieuws wordt gecreëerd door bestaande elementen te combineren. In dezelfde context verwijzen synthetische patiëntgegevens naar kunstmatig gegenereerde gegevens uit reeds bestaande echte patiëntgegevens.
In dit proces bestuderen statistische modellen en algoritmen grote hoeveelheden patiëntgegevens, observeren ze patronen en kenmerken en genereren ze datasets die echte gegevens emuleren. Enkele veel voorkomende technieken die worden ingezet bij het genereren van kunstmatige patiëntgegevens zijn:
- Generatieve vijandige netwerken (GNN's)
- Statistische modellen
- Methoden voor gegevensanonimisering en meer
Synthetische gegevens zijn een uitstekende en waterdichte techniek om privacyproblemen met betrekking tot de kans op het onthullen van heridentificeerbare patiëntinformatie te ondervangen. Laten we, om de voordelen van dergelijke gegevens te begrijpen, eens kijken naar enkele van de meest prominente gebruiksscenario's.
Gebruiksscenario's voor synthetische gegevens
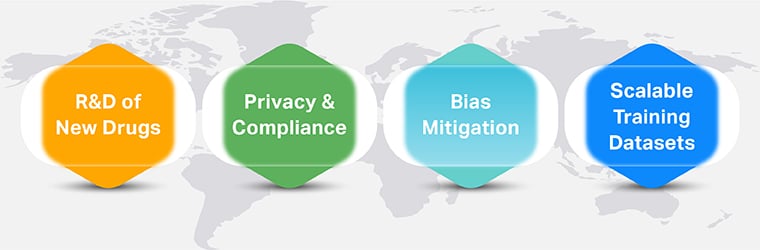
R&D van nieuwe medicijnen en medicijnen
Het genereren van gegevens voor klinische studies gebeurt discreet en organisaties houden vaak cruciale informatie geheim. Voor onderzoeks- en ontwikkelingsdoeleinden is data-interoperabiliteit echter essentieel voor het mogelijk maken van doorbraken. Het genereren van synthetische data kan onderzoekers helpen om belangrijke, traceerbare informatie te verbergen en data uit silo's te halen, zodat gezamenlijk onderzoek kan worden gedaan naar geneesmiddelreacties en -tegenwerkingen, formuleringen, correlaties tussen resultaten en meer.
Privacy en naleving van regelgeving
Hoewel er gesprekken gaande zijn over de behoefte aan gecentraliseerde cloudgebaseerde EPD-systemen, zijn er ook uitdagingen op regelgevingsgebied rond privacy- en veiligheidsproblemen. Hoewel interoperabiliteit van gegevens onvermijdelijk is, moeten belanghebbenden in het hele spectrum van de gezondheidszorg uiterst waakzaam zijn bij het delen van patiëntgegevens. Synthetische data kunnen helpen gevoelige aspecten te verbergen, terwijl ze toch de belangrijkste contactpunten behouden en dienen als ideale representatieve datasets.
Mitigatie van bias in de gezondheidszorg
In de gezondheidszorg is de introductie van vooringenomenheid aangeboren en onvermijdelijk. Als er bijvoorbeeld een epidemie uitbreekt op een geografische locatie die mannen tussen de 35 en 50 jaar treft, wordt er standaard vooroordelen geïntroduceerd voor deze specifieke persoonlijkheid. Hoewel vrouwen en kinderen nog steeds kwetsbaar zijn voor deze uitbraak, hebben onderzoekers objectieve grond nodig om hun bevindingen te onderbouwen. Synthetische data kunnen helpen bij het elimineren van vooroordelen en het leveren van evenwichtige representaties.
Schaalbare datasets voor gezondheidszorgtrainingen
Als gevolg van regelgeving als GDPR, HIPAA en meer blijft de beschikbaarheid van datasets voor het trainen van geavanceerde machine learning-modellen uit de gezondheidszorg zuinig. Kunstmatige intelligentie (AI)-systemen en machine learning-modellen vereisen enorme hoeveelheden trainingsgegevens om steeds beter te worden in het leveren van nauwkeurige resultaten.
Het genereren van synthetische data is een zegen in deze sector, omdat organisaties hiermee kunstmatige data kunnen genereren die is afgestemd op hun volumebehoeften, specificaties en resultaten, en tegelijkertijd ethisch gebruik van synthetische data kunnen stimuleren.
Tekortkomingen en valkuilen van synthetische gezondheidszorggegevens
Het feit dat er systemen en modules bestaan om op kunstmatige wijze patiënt- en gezondheidszorggegevens te genereren uit bestaande datasets is geruststellend. Deze techniek is echter niet zonder een groot aantal tekortkomingen. Laten we begrijpen wat ze zijn.