Elk computervisieteam loopt uiteindelijk tegen hetzelfde probleem aan: de data die je het hardst nodig hebt, is juist de data die je niet kunt verkrijgen. De bijna-aanrijding op het kruispunt. Het defect dat slechts eens in tienduizend exemplaren voorkomt. Het scenario dat te gevaarlijk, te zeldzaam of te privé is om vast te leggen met een camera.
Hier komt synthetische data om de hoek kijken: computergegenereerde beelden en scènes die de lacunes opvullen die met echte dataverzameling niet bereikt kunnen worden. Maar synthetische data is een hulpmiddel, geen wondermiddel, en teams die het als een makkelijke prooi beschouwen, ontdekken al snel de zwakke punten ervan in de praktijk. Hieronder een heldere blik op wanneer het helpt, wanneer het averechts werkt en hoe je het goed kunt gebruiken.
Gebruik synthetische data wanneer dat nodig is.
Vijf situaties rechtvaardigen consequent het gebruik van synthetische data.

Zeldzame randgevallen. Bijna-ongelukken, ongebruikelijke interacties tussen objecten, ongewone scenario's — de gebeurtenissen die het meest van belang zijn voor de veiligheid en robuustheid, zijn precies de gebeurtenissen die nauwelijks in uw echte dataset voorkomen. Synthetische generatie stelt u in staat om duizend variaties te creëren van een gebeurtenis die u slechts twee keer hebt gezien.
Gecontroleerde dekking. Real-world opnames geven je de belichting, achtergronden, mate van occlusie en camerahoeken die je toevallig hebt vastgelegd. Synthetische pipelines stellen je in staat om deze variabelen systematisch te variëren — elke zonhoek, elke gedeeltelijke occlusie, elke lenshoogte — zodat de dekking een bewuste ontwerpkeuze wordt in plaats van een toeval.
Snelle iteratie. Wanneer je een model bootstrapt voordat je grootschalige data verzamelt, wordt een eerste versie van de synthetische data binnen enkele dagen getraind in plaats van maanden. Je leert waar het model moeite mee heeft voordat je het budget voor de dataverzameling besteedt.
Privacy- en nalevingsbeperkingen. In gevoelige omgevingen waar het vastleggen van echte gezichten beperkt is – ziekenhuizen, scholen, werkplekken met strenge privacyregels – bieden synthetische scènes een trainingssignaal zonder dat er ook maar één echt gezicht of identiteit in het proces voorkomt.
Ondersteuning voor klassenbalans. Wanneer sommige klassen sterk ondervertegenwoordigd zijn, trainen modellen instabiel en negeren ze de minderheid. Synthetische voorbeelden kunnen ondervertegenwoordigde klassen versterken om de trainingsstabiliteit te herstellen.
De valkuilen: Synthetische stoffen kunnen averechts werken als
Nu het eerlijke gedeelte. Synthetische data falen op voorspelbare manieren, en elk van die fouten is te voorkomen als je weet waar je op moet letten.
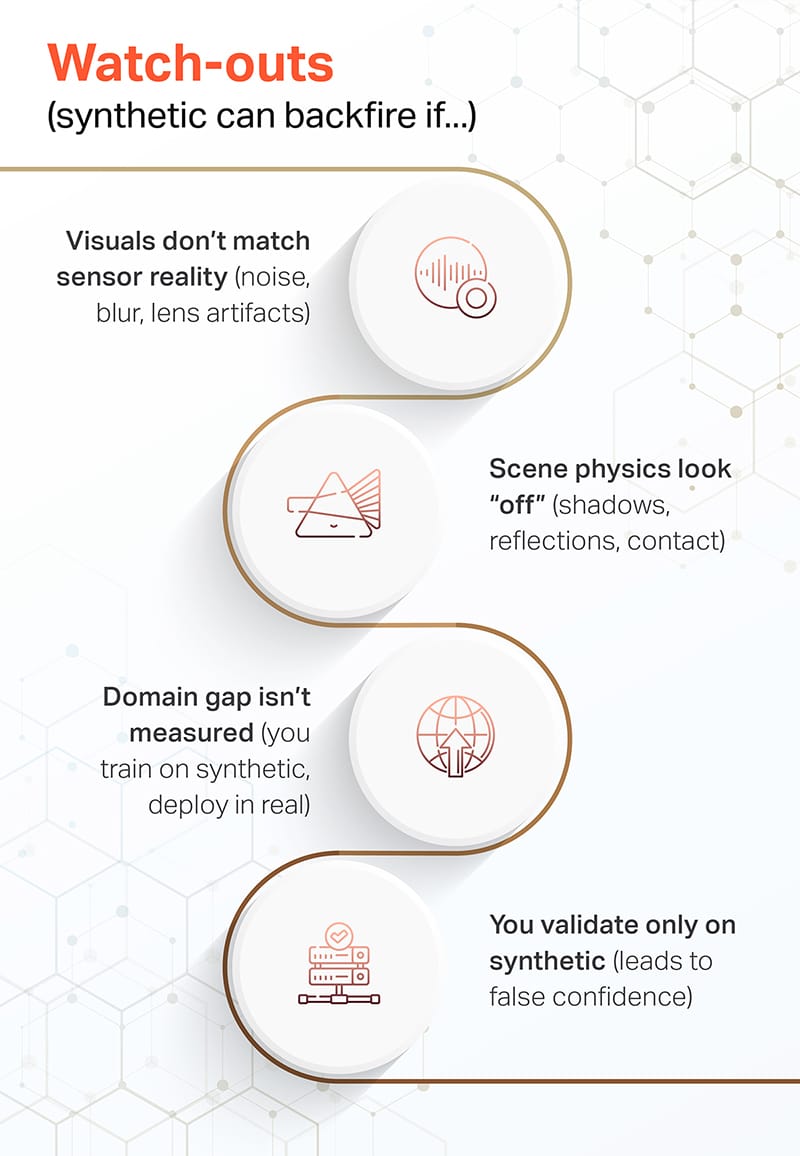
De beelden komen niet overeen met de werkelijkheid zoals die door de sensor wordt gemeten. Je camera tijdens de uitzending vertoont ruis, onscherpte en lensartefacten. Als je synthetische beelden schoner zijn dan alles wat je sensor ooit zal produceren, leert het model een wereld die niet bestaat.
De natuurkundige eigenschappen van de scène lijken "vreemd". Schaduwen die de verkeerde kant op vallen, reflecties die zich niet gedragen zoals verwacht, objecten die niet helemaal contact maken met oppervlakken. Mensen halen hun schouders hierover op; modellen nemen ze als de werkelijke situatie over.
Het verschil tussen domeinen wordt niet gemeten. De klassieke fout: trainen op een synthetische omgeving, implementeren in de praktijk en nooit het verschil tussen beide kwantificeren. Als je het verschil tussen domeinen niet meet, ben je aan het gokken.
Je valideert alleen op synthetische data. Dit is de gevaarlijkste methode, omdat het een vals gevoel van zekerheid geeft: een model dat uitstekend presteert op synthetische testsets, maar faalt op echte data. Synthetische validatie vertelt je dat het model je simulator heeft geleerd, niet de werkelijke wereld.
De beste praktijkbenadering
Teams die succesvol omgaan met synthetische data volgen dezelfde cyclus van vijf stappen.
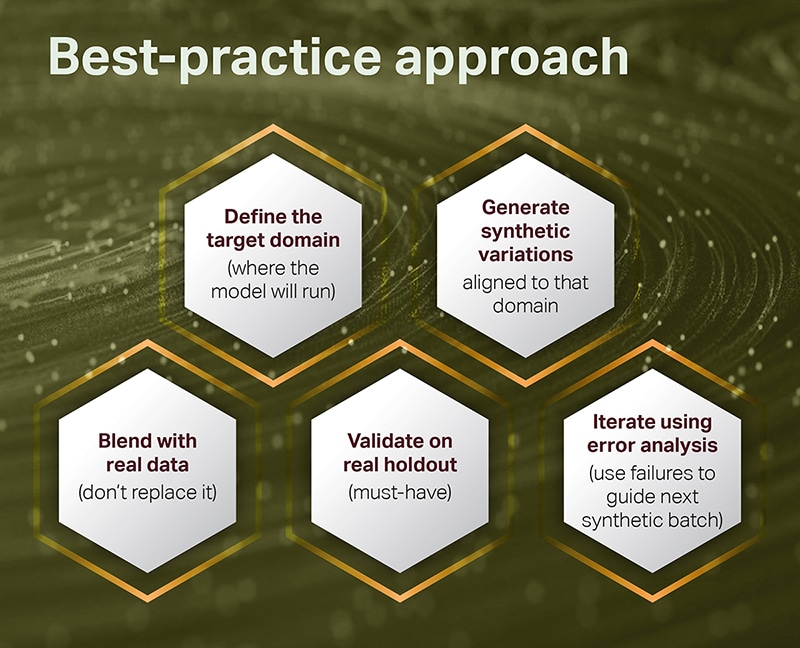
Definieer eerst het doeldomein : de daadwerkelijke omstandigheden waaronder het model zal draaien, tot aan de sensor, omgeving en belichting toe. Genereer vervolgens synthetische varianten die zijn afgestemd op dat domein , geen generieke, mooie weergaven. Combineer ten slotte met echte data : synthetische data vullen echte opnames aan, ze vervangen ze niet. Valideer ten vierde op een echte testset . Dit is absoluut noodzakelijk: uw benchmark moet bestaan uit echte data die het model nog nooit heeft gezien. En ten vijfde, herhaal het proces met behulp van foutenanalyse : laat de fouten van het model in de praktijk bepalen wat de volgende reeks synthetische data moet bevatten.
Definieer → genereer → combineer → valideer op de werkelijkheid → herhaal. De lus is belangrijker dan elke afzonderlijke stap.
Moet je synthetische data gebruiken? Een snel besluitvormingskader.
Vier vragen beslechten de meeste discussies.
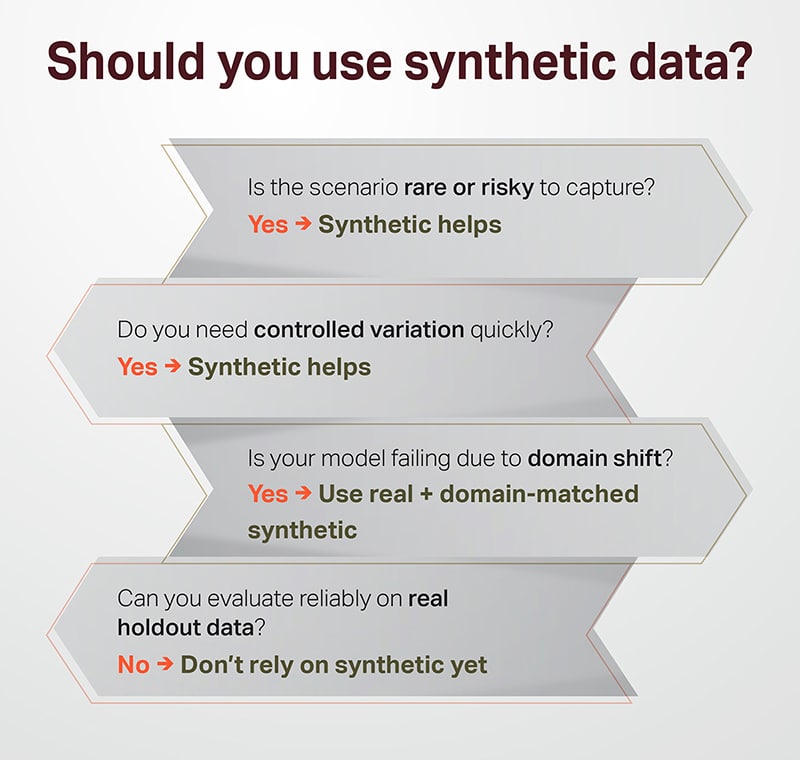
Is het scenario zeldzaam of riskant om vast te leggen ? Zo ja, dan helpt synthetische data. Heeft u snel gecontroleerde variatie nodig ? Zo ja, dan helpt synthetische data. Faalt uw model door domeinverschuiving ? Zo ja, gebruik dan echte data plus domein-gematchte synthetische data — synthetische data alleen kunnen een hiaat niet dichten dat ze niet kunnen zien. En tot slot: kunt u betrouwbaar evalueren op echte testdata ? Zo nee, vertrouw dan nog niet op synthetische data — bouw eerst uw echte evaluatieset op, want zonder die set kunt u niet vaststellen of synthetische data helpen of juist stiekem schade toebrengen.
The Bottom Line
Synthetische data is een van de krachtigste tools in de gereedschapskist van computervisie – voor uitzonderlijke gevallen, dekking, snelheid, privacy en balans. Het is echter ook een van de tools die het gemakkelijkst misbruikt kunnen worden, omdat de zwakke punten verborgen blijven achter ogenschijnlijk goede statistieken tot de dag van implementatie.
De teams die het goed doen, benaderen het als een technische discipline: echte data als basis, synthetische data als gerichte versterking en validatie in de praktijk als ononderhandelbare scheidsrechter. Dat is de aanpak die Shaip hanteert met CV-teams: het plannen van de juiste mix van echte en synthetische data, met meetbare kwaliteitsborging en implementatiegerichte validatie, zodat het model dat werkt tijdens de training ook werkt in de praktijk.