
Dataset voor machinaal leren
Koop en licentieer hoogwaardige AI-trainingsdatasets | AI-datacatalogus en licentiemarktplaats
De AI-datacatalogus en licentiemarktplaats van Shaip biedt AI-teams één centrale plek voor de aanschaf en licentie van vooraf gelabelde, commercieel goedgekeurde trainingsdatasets in tekst-, spraak-, beeld-, video- en multimodale formaten. Elke dataset is handmatig gelabeld, ethisch verantwoord verkregen en direct klaar voor gebruik, inclusief volledige documentatie voor naleving van de AVG, HIPAA en de vereisten voor gegevensbeheer binnen de organisatie.
Of u nu een groot taalmodel verfijnt, een diagnostisch systeem voor de gezondheidszorg traint of een computervisie-pipeline versnelt, de catalogus van Shaip omvat meer dan 10 branches met flexibele licentieopties: eenmalige aankoop, abonnementstoegang of aangepaste bedrijfscontracten. Vraag een gratis voorbeeldgegevensset aan om de kwaliteit te controleren voordat u een definitieve keuze maakt.
We geven prioriteit aan ethische data sourcing in al onze activiteiten, om zo een verantwoorde en eerlijke AI-ontwikkeling te garanderen. Onze rigoureuze en transparante praktijken in dataverzameling, validatie en verwerking beschermen de privacy en behouden het vertrouwen van zowel onze klanten als dataleveranciers.
Fysieke AI-datacatalogus
Het succes van robotleerprogramma's hangt volledig af van de kwaliteit en consistentie van hun demonstratiegegevens. Onze Physical AI-catalogus levert demonstraties van mensen, multimodale perceptiegegevens en robotstatus-actie-episodes die zijn verzameld aan de hand van een gestandaardiseerde taakbibliotheek. Dit geeft uw VLA-, humanoïde-, manipulatie- en Real2Sim-pipelines de schone, vergelijkbare episodes die ze nodig hebben voor betrouwbare training en evaluatie.
Kant-en-klare fysieke AI-datacatalogus en licenties:
- Meer dan 1,400 gedocumenteerde taakscenario's in 9 praktijksituaties (huishouden, industrie, detailhandel, horeca en meer).
- Demonstratiesessies met menselijke proefpersonen en VLA-trainingssessies met consistente beginsituaties en succescriteria.
- Egocentrische en multi-view video met vastlegging van beweging, houding en behendigheid.
- Afleveringen duren 0.5 tot 10 minuten en zijn verdeeld over 4 moeilijkheidsniveaus, inclusief het gebruik van gereedschap.

Spraakgegevenscatalogus
Er is een grote verscheidenheid aan veelgebruikte toepassingen voor spraakgegevens in AI-projecten. We bieden u enorme hoeveelheden hoogwaardige gegevens die klaar zijn voor uw spraakherkenningsproducten die passen bij uw budget en die kunnen worden geschaald naarmate u groeit om uw AI / ML-modellen te trainen.
Kant-en-klare spraakgegevenscatalogus en licenties:
- 55k+ uur aan spraakgegevens (50+ talen/100+ dialecten)
- 70+ onderwerpen behandeld
- Bemonsteringsfrequentie – 8/16/44/48 kHz
- Audiotype - Spontaan, gescript, monoloog, wakker wordende woorden
- Volledig getranscribeerde audiodatasets in meerdere talen voor mens-mensgesprekken, mens-bot, mens-agent callcentergesprekken, monologen, toespraken, podcast, enz.
- Uitspraaklexicons, zowel algemeen als domeinspecifiek (bijv. namen, plaatsen, natuurlijke getallen)

Medische gegevenscatalogus
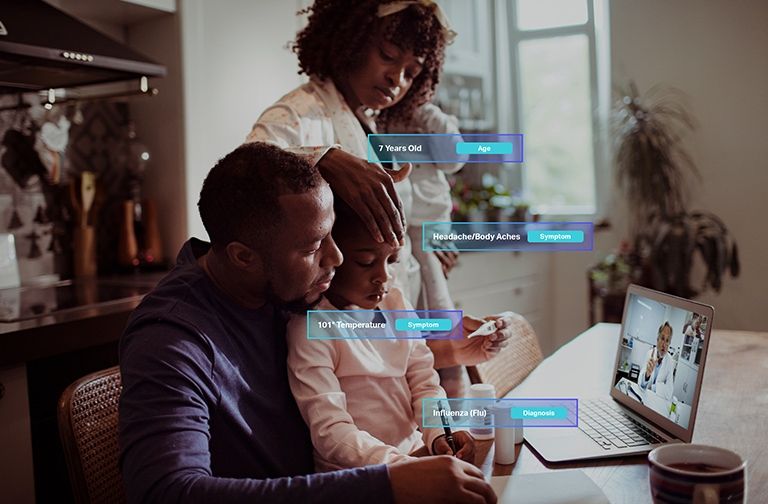
De datasets van onze medische datacatalogus zijn niet alleen enorm, maar bevatten ook kwaliteitsgegevens van de gouden standaard. U kunt er zeker van zijn dat de gegevens die u gebruikt, veilig en niet-geïdentificeerd zijn en kunnen worden vertrouwd voor het behalen van de hoogste en meest nauwkeurige resultaten voor uw AI-initiatief, machine learning-modellen, natuurlijke taalverwerking en andere ontwikkelingsprojecten.
Kant-en-klare medische gegevenscatalogus en licenties:
- Meer dan 5 miljoen elektronische medische dossiers en audiobestanden van artsen in 31 specialismen
- 2M+ Medische beelden in radiologie en andere specialismen (MRI's, CT's, USG's, XR's)
- 30k+ klinische tekstdocumenten met entiteiten met toegevoegde waarde en relatieannotatie
Computer Vision-gegevenscatalogus
Er is een grote verscheidenheid aan veelvoorkomende toepassingen voor Computer Vision in AI-projecten. We bieden u enorme hoeveelheden beeld- en videogegevens van hoge kwaliteit die klaar zijn voor uw computer vision-modellen die passen bij uw budget en die kunnen worden geschaald naarmate u groeit.
Beeld- en videogegevenscatalogus en licenties:
- Voedsel/Document Afbeeldingscollectie
- Videocollectie voor huisbeveiliging
- Gezichtsbeeld/videocollectie
- Facturen, PO, ontvangsten Documentverzameling voor OCR
- Beeldverzameling voor detectie van voertuigschade
- Verzameling kentekenplaatafbeeldingen
- Collectie auto-interieurafbeeldingen
- Beeldverzameling met autobestuurder in focus
- Modegerelateerde afbeeldingscollectie
- Op drones gebaseerde videoverzameling en annotatie
- Video-/afbeeldingenverzameling voor gehandicapte personen
- Monumentale afbeeldingscollectie
- Barcode scannen afbeeldingsverzameling

Gegevenssets openen
Via de Shaip-bibliotheek met open datasets heeft uw team gratis toegang tot een uitgebreide AI-gegevensopslag. Nu kunt u snel en nauwkeurig uw AI- en ML-modellen ontwikkelen voor uw specifieke bedrijfsresultaten zonder bijbehorende kosten.
Beschikbare open datasets:
- Verkrijgbaar in een handige en aanpasbare vorm
- Grote categorieën datasets
- Gratis voor gebruik met uw AI- en ML-projecten
- Hoge kwaliteit, gouden standaardgegevens

Beveiliging en naleving


Plan een demo om te ontdekken hoe Shaip aan al uw vereisten voor trainingsgegevens kan voldoen.
Van dataverzameling tot annotatie, licentieverlening en validatie: wij helpen u sneller de markt te bereiken met betrouwbare data.
ContactVeel gestelde vragen (FAQ)
1. Wat is datacataloguslicentie?
Met datacataloguslicenties kunnen bedrijven toegang tot gecureerde datasets aanschaffen of in licentie geven voor gebruik in AI-projecten. Deze datasets bevatten tekst-, spraak-, beeld- of videodata, zorgvuldig samengesteld om aan specifieke eisen te voldoen. Licenties garanderen dat bedrijven de data legaal kunnen gebruiken en zich houden aan privacy- en compliancenormen.
2. Hoe worden de trainingsdatasets voor de AI van Shaip verzameld en gelabeld?
Shaip verzamelt gegevens via een wereldwijd netwerk van geverifieerde bijdragers in meer dan 60 landen, met behulp van Shaips eigen verzamelplatform. Alle datasets ondergaan een kwaliteitscontrole op meerdere niveaus door annotatoren met domeinexpertise, geautomatiseerde validatiecontroles en een laatste beoordeling door een mens voordat ze worden opgeleverd. De nauwkeurigheid van de labels is hoger dan 95% voor alle cataloguscategorieën.
3. Kan Shaip datasets schalen om te voldoen aan de groeiende projectbehoeften?
Ja, de datasets van Shaip zijn schaalbaar. Of u nu kleine datasets nodig hebt voor tests of grote volumes om AI-modellen op ondernemingsniveau te trainen, Shaips wereldwijde netwerk kan data leveren die aan de eisen van uw project voldoen.
4. Hoeveel kost het om kant-en-klare datasets te licenseren?
De licentiekosten zijn afhankelijk van factoren zoals datatype, volume, maatwerk en gebruiksrechten. Shaip biedt flexibele prijzen die aansluiten op verschillende budgetten en projectbehoeften. Neem contact op met het team voor een offerte op maat.
5. Kan ik een voorbeeldgegevensset aanvragen?
Ja, Shaip biedt voorbeeldgegevenssets aan waarmee u de kwaliteit en relevantie van de gegevens voor uw project kunt beoordelen. Neem contact op met het team om een demo in te plannen of een voorbeeld aan te vragen.
6. Waar kan ik gelicentieerde AI-trainingsdatasets kopen voor commercieel gebruik?
De AI-datacatalogus van Shaip biedt vooraf gelabelde datasets die direct commercieel gelicentieerd kunnen worden in tekst-, spraak-, beeld-, video- en multimodale formaten. Alle datasets worden geleverd met duidelijke commerciële licentiedocumentatie – GDPR- en HIPAA-conform – met opties voor eenmalige aankoop, jaarabonnement of bedrijfsbrede overeenkomst. Vraag een gratis voorbeeld aan om de kwaliteit te controleren voordat u tot aankoop overgaat.
7. Hoe koop ik GDPR- en HIPAA-conforme datasets voor het trainen van AI-modellen?
De volledige datasetcatalogus van Shaip is ontwikkeld om te voldoen aan de GDPR- en HIPAA-regelgeving. Elke dataset bevat toestemmingsdocumentatie, geanonimiseerde gegevens (voor medische gegevens), metadata over de herkomst van de gegevens en auditklare compliance-documenten. Organisaties die onder de GDPR, HIPAA, CCPA of ISO 27001 vallen, kunnen datasets met volledige documentatie zonder extra kosten in licentie nemen.
8. Welke soorten vooraf gelabelde multimodale datasets kan ik van Shaip in licentie nemen?
Shaip biedt multimodale datasets aan die tekst-, spraak-, beeld- en videogegevens combineren, waaronder egocentrische video voor fysieke AI, datasets met menselijke demonstraties voor robotica en gecombineerde tekst-beeldcorpora voor het finetunen van GenAI. Alle multimodale datasets bevatten metadata, annotaties op modaliteitsniveau en commerciële licentievoorwaarden. Gratis voorbeelden zijn op aanvraag beschikbaar.
