In onze inspanningen om robuuste en onbevooroordeelde AI-oplossingen te ontwikkelen, is het van essentieel belang dat we ons richten op het trainen van de modellen met een onbevooroordeelde, dynamische en representatieve verzameling gegevens. Ons dataverzamelingsproces is van cruciaal belang voor de ontwikkeling van geloofwaardige AI-oplossingen. In dit verband is het verzamelen van AI-trainingsgegevens via crowdsourcing een essentieel onderdeel van de dataverzamelingsstrategie.
In dit artikel onderzoeken we de rol van crowdworkers, de impact ervan op de ontwikkeling van AI- leeralgoritmen en machine learning-modellen, en de noodzaak en voordelen die het biedt voor het gehele proces.
Waarom zijn crowdwerkers nodig om AI-modellen te bouwen?
Als mensen genereren we enorme hoeveelheden data, maar slechts een fractie daarvan is waardevol. Door het gebrek aan standaarden voor databenchmarking is het grootste deel van de verzamelde data ofwel bevooroordeeld, vol met kwaliteitsproblemen, of niet representatief voor de omgeving. Omdat er steeds meer machine learning- en deep learning-modellen worden ontwikkeld die gedijen op enorme hoeveelheden data, groeit de behoefte aan betere, nieuwere en diverse datasets.
Het is waar crowdwerkers in het spel komen.
Crowdsourcing data is het opbouwen van een dataset met deelname van grote groepen mensen. Crowdwerkers voegen menselijke intelligentie toe aan kunstmatige intelligentie.
Crowdsourcingplatforms geven microtaken voor dataverzameling en -annotatie aan een grote en diverse groep mensen. Dankzij crowdsourcing krijgen bedrijven toegang tot een enorm, dynamisch, kosteneffectief en schaalbaar personeelsbestand.
Het populairste crowdsourcingplatform – Amazon Mechanical Turk – slaagde erin om binnen 15 uur 11 mens-tot-mensgesprekken te genereren en betaalde de deelnemers $0.35 voor elk succesvol gesprek. Dat crowdsourcingmedewerkers voor zo'n schamel bedrag worden ingehuurd, onderstreept het belang van ethische normen voor dataverzameling.
Theoretisch klinkt het als een slim plan, maar het is geen gemakkelijke strategie om uit te voeren. De anonimiteit van de crowdwerkers heeft geleid tot problemen met lage lonen, minachting voor werknemersrechten en werk van slechte kwaliteit dat van invloed is op de prestaties van het AI-model.
Voordelen van het hebben van crowdwerkers om gegevens te verzamelen
Door een diverse groep crowdwerkers in dienst te nemen, kunnen op AI gebaseerde oplossingsontwikkelaars snel en tegen relatief lage kosten microtaken verdelen en gevarieerde en wijdverbreide observaties verzamelen.
Enkele van de belangrijkste voordelen van het inhuren van crowdwerkers voor AI-projecten zijn:
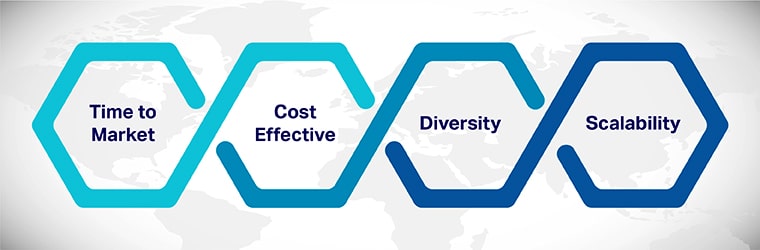
Snellere time-to-market: Volgens onderzoek van Cognilytica wordt bijna 80% van de tijd die aan kunstmatige intelligentieprojecten wordt besteed, besteed aan dataverzameling, zoals het opschonen, labelen en aggregeren van data. Slechts 20% van de tijd wordt besteed aan ontwikkeling en training. De traditionele belemmeringen voor het genereren van data worden weggenomen, omdat een groot aantal bijdragers in korte tijd kan worden gerekruteerd.
Kosteneffectieve oplossing: Het verzamelen van data via crowdsourcing vermindert de tijd en energie die nodig is voor training, werving en inwerkingtreding van medewerkers. Dit elimineert de kosten, tijd en middelen die nodig zijn omdat de medewerkers per taak betaald worden.
Bevordert de diversiteit in de dataset: Datadiversiteit is cruciaal voor de training van de gehele AI-oplossing. Om een model onbevooroordeelde resultaten te laten produceren, moet het getraind worden op een diverse dataset. Met crowdsourcing van data is het mogelijk om met weinig moeite en kosten diverse datasets te genereren (qua geografische locatie, talen en dialecten).
Verbeterde schaalbaarheid: Door betrouwbare crowdworkers in te schakelen, bent u verzekerd van hoogwaardige dataverzameling die kan worden opgeschaald naar de behoeften van uw project.

In-house vs. crowdsourcing – Wie komt er als winnaar uit de bus?
| Interne gegevens | Crowdsourced gegevens |
|---|---|
| De nauwkeurigheid en consistentie van de gegevens kunnen worden gegarandeerd. | De kwaliteit, nauwkeurigheid en consistentie van gegevens kunnen worden gehandhaafd als betrouwbare crowdsourcingplatforms met standaard QA-maatregelen worden gebruikt |
| Interne datasourcing is niet altijd een praktische beslissing, aangezien uw interne team mogelijk niet aan de projecteisen voldoet. | Datadiversiteit kan worden gegarandeerd omdat het mogelijk is om een heterogene groep crowdwerkers te rekruteren op basis van de projectbehoeften. |
| Duur om werknemers te werven en op te leiden voor de projectbehoeften. | Kostenbesparende oplossing voor het verzamelen van gegevens omdat het mogelijk is om met minder investeringen werknemers aan te werven, op te leiden en in dienst te nemen. |
| De time-to-market is hoog omdat het intern verzamelen van gegevens veel tijd kost. | De time-to-market is aanzienlijk korter omdat veel bijdragen snel binnenkomen. |
| Een kleine groep interne bijdragers en labelers | Een grote en diverse groep donateurs en gegevens labelers |
| De vertrouwelijkheid van gegevens is erg hoog met een in-house team. | De vertrouwelijkheid van gegevens is moeilijk te handhaven bij het werken met grote crowdwerkers over de hele wereld. |
| Gemakkelijker om de gegevensverzamelaars te volgen, te trainen en te evalueren | Uitdagend om de gegevensverzamelaars te volgen en te trainen. |
Het overbruggen van de kloof tussen crowdsourcers en de aanvrager.
Er is een schrijnend gebrek aan informatie vanuit de opdrachtgever, omdat de medewerkers alleen informatie krijgen over de specifieke taak. Hoewel medewerkers bijvoorbeeld microtaken krijgen, zoals het opnemen van dialogen in hun moedertaal, krijgen ze zelden context. Ze beschikken niet over de benodigde informatie over waarom ze doen wat ze doen en hoe ze het het beste kunnen doen. Dit gebrek aan informatie heeft een negatieve invloed op de kwaliteit van het crowdsourced werk.
Voor een mens zorgt het hebben van de volledige context voor duidelijkheid en doel in zijn werk.
Voeg aan deze mix nog een dimensie van NDA toe: de geheimhoudingsovereenkomsten die de hoeveelheid informatie beperken die een crowdwerker wordt verstrekt. Vanuit het perspectief van een crowdworker toont deze terugtrekking van informatie een gebrek aan vertrouwen en verminderd belang voor hun werk.
Wanneer dezelfde situatie vanuit het andere perspectief wordt bekeken, blijkt er een gebrek aan transparantie te zijn aan de kant van de werknemer. De opdrachtgever begrijpt de werknemer die de opdracht krijgt niet volledig. Sommige projecten vereisen wellicht een specifiek type werknemer; in de meeste projecten is er echter sprake van onduidelijkheid. In de praktijk kan dit de evaluatie, feedback en training in de toekomst bemoeilijken.
Om deze moeilijkheden het hoofd te bieden, is het belangrijk om samen te werken met experts op het gebied van gegevensverzameling met een staat van dienst in het leveren van diverse, samengestelde en goed vertegenwoordigde gegevens van een brede selectie van bijdragers.
Het kiezen van Shaip als uw datapartner kan meerdere voordelen hebben. We richten ons op diversiteit en representatieve distributies van data. Onze ervaren en toegewijde medewerkers begrijpen de dwang van elk project en ontwikkelen datasets die in een mum van tijd robuuste op AI gebaseerde oplossingen kunnen trainen.
[Lees ook: Handleiding voor AI-trainingsdata: definitie, voorbeeld, datasets ]