Stel je voor dat je een spraakassistent vraagt om een lange vergadering samen te vatten, deze in het Spaans te vertalen en de actiepunten in je CRM te zetten – allemaal vanuit één enkel spraakbericht.
Achter die "magie" schuilt niet alleen een krachtig model zoals Whisper of een LLM zoals Gemini of ChatGPT. Het zijn de spraakherkenningsdatasets die gebruikt worden om die modellen te trainen en te verfijnen.
In 2025 is spraak- en stemherkenning een markt van vele miljarden dollars, die naar verwachting in 2032 de 80 miljard dollar zal overschrijden.
Als uw AI-product afhankelijk is van gesproken input – of het nu gaat om gesprekken met een contactcenter, dicteren of spraakgestuurd zoeken – bepalen de kwaliteit, diversiteit en wettigheid van uw spraakdatasets hoe goed uw AI "luistert".
In dit artikel zullen we het hebben over de diverse datasets voor spraakherkenning. We onderzoeken hun typen om u te helpen de beste datasets voor uw AI-model te kiezen.
Maar laten we eerst eens ingaan op enkele basisprincipes.
Wat is een spraakherkenningsdataset?
Een persoon uit Texas klinkt bijvoorbeeld anders dan iemand uit Londen, ook al zegt hij dezelfde zin. Een goede dataset legt deze diversiteit vast. Het helpt de AI om de nuances van menselijke spraak te horen en te begrijpen.
Deze dataset speelt een cruciale rol bij de ontwikkeling van AI-modellen. Het levert de gegevens die de AI nodig heeft om taalbegrip en -productie te leren. Met een rijke en diverse dataset wordt een AI-model beter in staat menselijke taal te begrijpen en ermee te interacteren. Daarom kan een dataset voor spraakherkenning u helpen bij het creëren van intelligente, responsieve en nauwkeurige spraak-AI-modellen.
Waarom heeft u een hoogwaardige spraakherkenningsdataset nodig?
Met de opkomst van spraak-native LLM's ontstaan er nieuwe soorten datasets:
- Expressieve spraak met beschrijvingen in natuurlijke taal (bijv. SpeechCraft) – ondersteunt het trainen van modellen die stijl, emotie en prosodie begrijpen.
- Synthetische spraakcorpora, gecreëerd met TTS + LLM-gegenereerde tekst (bijv. Magpie Speech), worden gebruikt om echte data aan te vullen.
- Datasets voor het detecteren van valse spraak/spoofing (bijv. LlamaPartialSpoof) voor spraakbeveiliging en fraudedetectie.
Gebruik dit wanneer: je werkt aan spraak- en taalmodellen, expressieve tekst-naar-spraak (TTS) of AI-veiligheid/fraudedetectie.
Hoe kies je de juiste dataset voor spraakherkenning (stap voor stap)?
Gebruik dit als een praktisch kader voor besluitvorming.
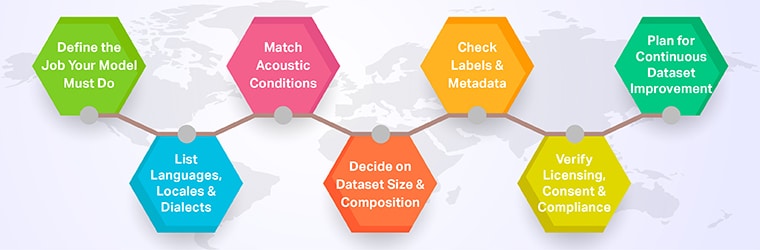
Stap 1 – Definieer de taak die uw model moet uitvoeren
- Taak: dicteren, spraakgestuurd zoeken, contactcenteranalyses, realtime ondertiteling, nalevingscontrole, enz.
- Kanaal: telefonie (8 kHz), mobiele app, slimme luidsprekers met groot bereik, microfoons in de auto.
- Kwaliteitsbalk: Doelstellingen voor WER, latentie, responstijden en wettelijke vereisten.
Stap 2 – Lijst met talen, regio's en dialecten
- Welke talen en varianten (bijv. Amerikaans Engels versus Indiaas Engels versus Singaporees Engels)?
- Heb je nodig code-mixed spraak (Hindi-Engels, Spaans-Engels, enz.)?
- Richt u zich op talen met beperkte middelen waar open data schaars is?
Stap 3 – Stem de akoestische omstandigheden af
- Telefonie versus breedband versus microfoonopstellingen met meerdere microfoons.
- Rustig kantoor versus lawaaierige straat versus rijdende auto.
- Microfoons voor dichtbij versus microfoons voor veraf.
Je dataset moet de omgevingen weerspiegelen waarin je gebruikers zich daadwerkelijk bevinden.
Stap 4 – Bepaal de grootte en samenstelling van de dataset
Vuistregels (niet strikt):
- Het verfijnen van een vooraf getraind model (Whisper, wav2vec2, enz.)
- Tientallen tot een paar honderd uur aan hoogwaardige, domeinspecifieke data kunnen een groot verschil maken.
- Een model helemaal vanaf nul trainen.
- Dit vergt doorgaans duizenden tot tienduizenden uren, waardoor veel teams beginnen met voorgeprogrammeerde systemen en hun budget richten op het verfijnen van de data.
mix:
- sommige schone gescripte gegevens (voor de basis van fonetiek, getallen).
- Realistisch gespreksgegevens (voor robuustheid).
- Domeinspecifieke randgevallen (zeldzame entiteiten, lange getallen, jargon).
Stap 5 – Controleer labels en metadata
Voor klassieke ASR heb je minimaal het volgende nodig:
- Nauwkeurige transcripties
- Basislabels voor sprekers
- Consistente regels voor interpunctie en hoofdlettergebruik
Voor LLM + ASR-pipelines heb je ook het volgende nodig:
- Sprekersbeurtsegmentatie (wie wat zei en wanneer)
- Oproep/gesprek resultaten (opgelost, geëscaleerd, klachttype)
- Entiteitsannotaties (namen, rekeningnummers, productnamen)
- Labels voor sentiment of emotie, indien relevant.
Met deze labels kunt u pijplijnen voor samenvatting, kwaliteitscontrole, coaching, routering en RAG-analyse bouwen bovenop transcripten – waar tegenwoordig veel zakelijke waarde te vinden is.
Stap 6 – Controleer vergunningen, toestemming en naleving
Voordat je gaat trainen:
- Is de dataset gelicentieerd voor commercieel gebruik (niet alleen onderzoek)?
- Zijn de sprekers geïnformeerd over en hebben zij toestemming gegeven voor dit gebruik?
- Worden persoonsgegevens en gevoelige gegevens verwerkt in overeenstemming met de AVG / HIPAA / lokale regelgeving?
Veel open datasets gebruiken licenties zoals CC-BY of CC0 , elk met verschillende verplichtingen. Bij twijfel is een juridische toetsing een ononderhandelbare stap.
Stap 7 – Plan voor continue verbetering van de dataset
Talen evolueren, uw product evolueert, en uw dataset zou dat ook moeten doen:
- Monitor fouten in de praktijk en voeg foutieve herkenningen terug aan je trainingsset.
- Voeg nieuwe entiteiten (merken, SKU's, wettelijke voorwaarden) toe naarmate uw domein verandert.
- Breng periodiek accenten en demografische gegevens in evenwicht om vooroordelen te verminderen.
Deze gesloten feedbacklus is vaak het grootste verschil tussen spraakproducten die "voldoende goed" zijn en spraakproducten die "marktleidend" zijn.
[Lees ook: Verbeter AI-modellen met onze hoogwaardige audio-datasets in Indiase talen .]
Hoe Shaip kan helpen
Als je in de fase zit van "Ik weet dat ik betere spraakdata nodig heb, maar ik weet niet waar ik moet beginnen" , kan Shaip je helpen:
- Controleer uw bestaande datasets en identificeer dekkingstekorten
- Zorgen voor kant-en-klare datasets voor spraakherkenning In meer dan 65 talen en tientallen domeinen (scripts, callcenters, activeringswoorden, TTS, enz.)
- Ontwerpen en uitvoeren gegevensverzameling op maat programma's (op afstand, in eigen land, meerdere apparaten)
- Handle annotatie, transcriptie, kwaliteitscontrole en anonimisering eind tot eind
Zo kan uw team zich concentreren op modellen en producten , terwijl wij ervoor zorgen dat uw AI beschikt over de hoogwaardige, conforme spraakgegevens die nodig zijn om te luisteren én te begrijpen.