
Elke dag produceert uw organisatie een berg tekst. Supporttickets, contracten, patiëntendossiers, klantbeoordelingen, e-mails, transcripties van telefoongesprekken. Ongeveer 80% van alle bedrijfsgegevens bestaat uit ongestructureerde tekst zoals deze – en tot voor kort kon bijna niets daarvan op grote schaal worden geanalyseerd. Het bleef gewoon ongebruikt liggen.
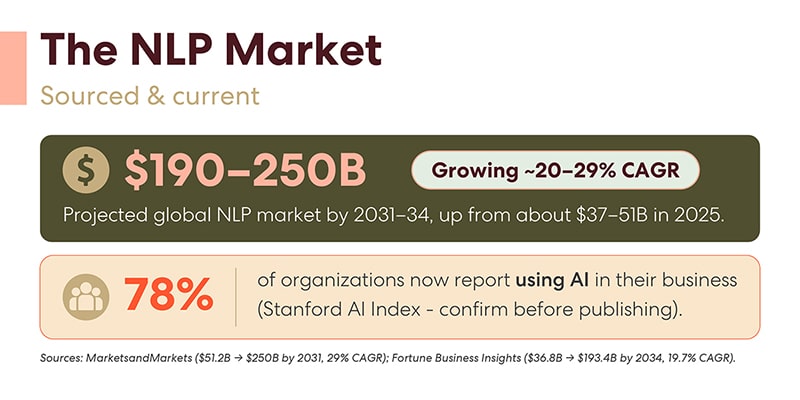
Natuurlijke taalverwerking (NLP) heeft daar verandering in gebracht. En in 2026, nu grote taalmodellen het zware werk doen, is NLP uitgegroeid van een nicheonderzoeksgebied tot de motor achter vrijwel elk AI-product dat je gebruikt. De markt weerspiegelt dit: analisten voorspellen dat NLP zal groeien van ongeveer $37-51 miljard in 2025 naar $190-250 miljard begin jaren 2030, en 78% van de organisaties geeft aan al AI in hun bedrijfsvoering te gebruiken.
Wat is NLP vandaag de dag precies, hoe werkt het in de praktijk en waar gaat het naartoe? Laten we het eens nader bekijken.
Laten we eerst de grootste verwarring uit de weg ruimen: NLP versus LLM
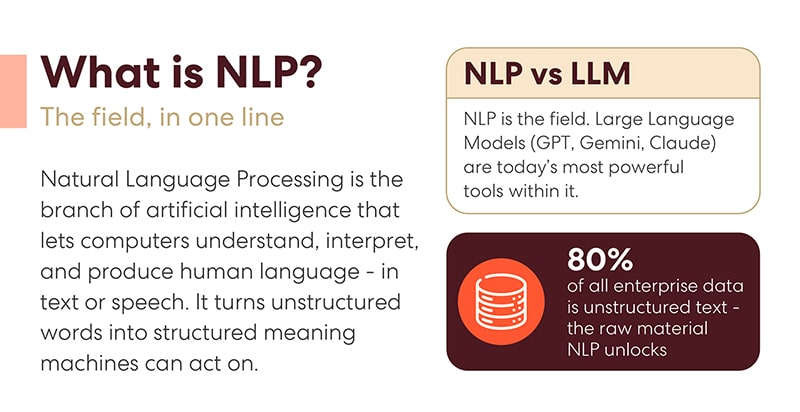
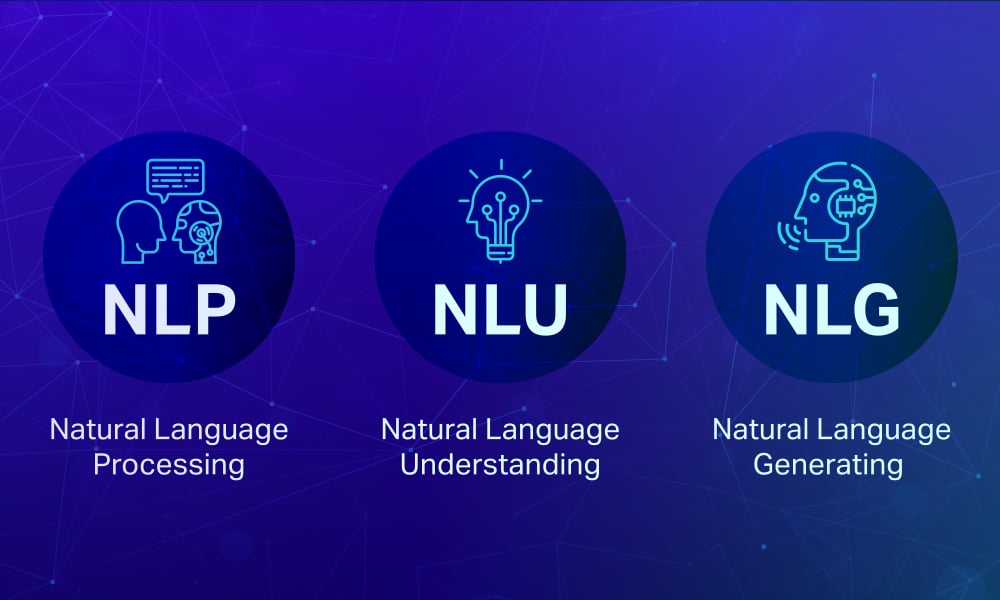
Vraag tien mensen wat het verschil is tussen NLP en een LLM, en je krijgt tien vage antwoorden. Hier is de duidelijke uitleg: NLP is het vakgebied – de gehele tak van AI die zich bezighoudt met machines die menselijke taal begrijpen, interpreteren en genereren. Grote taalmodellen zoals GPT, Gemini en Claude zijn tools binnen dat vakgebied. Ze zijn toevallig de krachtigste tools die NLP ooit heeft voortgebracht, waardoor de twee termen vaak door elkaar worden gehaald.
Zie het als de geneeskunde en MRI-apparaten. De MRI heeft de geneeskunde getransformeerd, maar niemand zegt dat geneeskunde gelijk staat aan MRI. Dezelfde relatie geldt voor elk LLM (Learning Learning Model). Elk LLM is een NLP-systeem (Natural Language Processing); NLP is veel groter dan welk afzonderlijk model dan ook.
Dit onderscheid is ook praktisch belangrijk. Veel zakelijke problemen – het doorsturen van een supportticket, het markeren van een contractclausule, het labelen van sentiment in reviews – vereisen geen geavanceerde LLM-technologie. Ze vereisen de juiste NLP-aanpak, die vaak kleiner, goedkoper en sneller is.
Hoe moderne NLP daadwerkelijk werkt
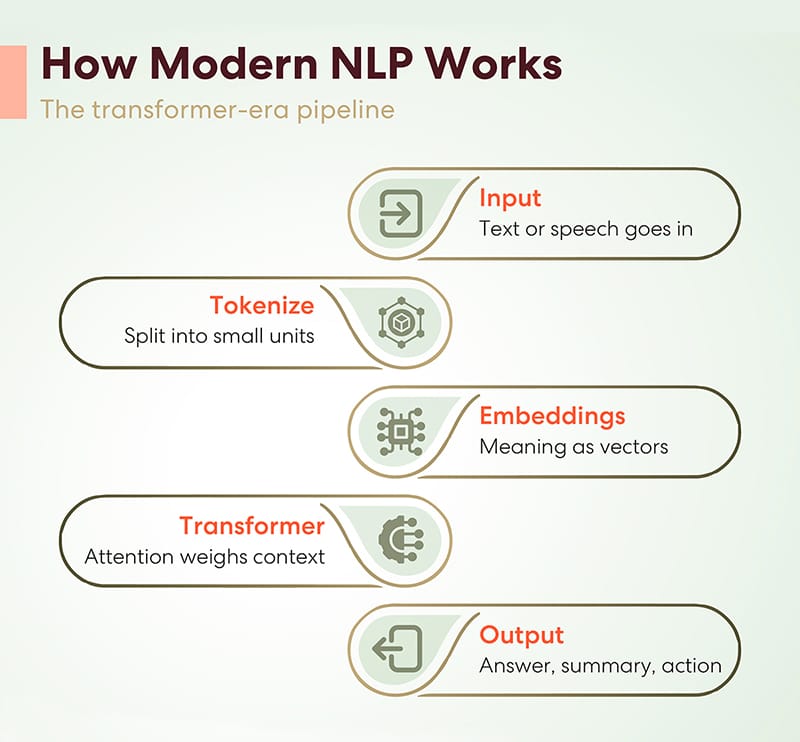
Zonder alle hype draait vrijwel elk modern NLP-systeem op hetzelfde vijfstappenplan.
Tekst of spraak komt binnen. Het systeem tokeniseert het, waarbij de taal wordt opgesplitst in kleine eenheden die het model kan verwerken. Deze tokens worden embeddings — numerieke vectoren die betekenis coderen, zodat 'arts' en 'dokter' dicht bij elkaar komen te liggen in de wiskundige ruimte. Dan komt het deel dat alles verandert: de transformer , waarvan het aandachtmechanisme elk token afweegt tegen elk ander token om te bepalen wat er in de context werkelijk toe doet. Zo weet een model dat in 'de bank keurde de lening goed' het niet over een rivier gaat. Ten slotte produceert het model een output — een antwoord, een samenvatting, een vertaling, een actie.
Dat is alles. Input → tokeniseren → inbedden → attenderen → output. De transformer-architectuur, die nog geen tien jaar geleden werd geïntroduceerd, vormt nu de basis van vrijwel elk taal-AI-systeem dat in productie is. Wanneer mensen het hebben over het "LLM-tijdperk", hebben ze het eigenlijk over het transformer-tijdperk op grote schaal.
Wat NLP kan doen – en hoe de functieomschrijving is veranderd
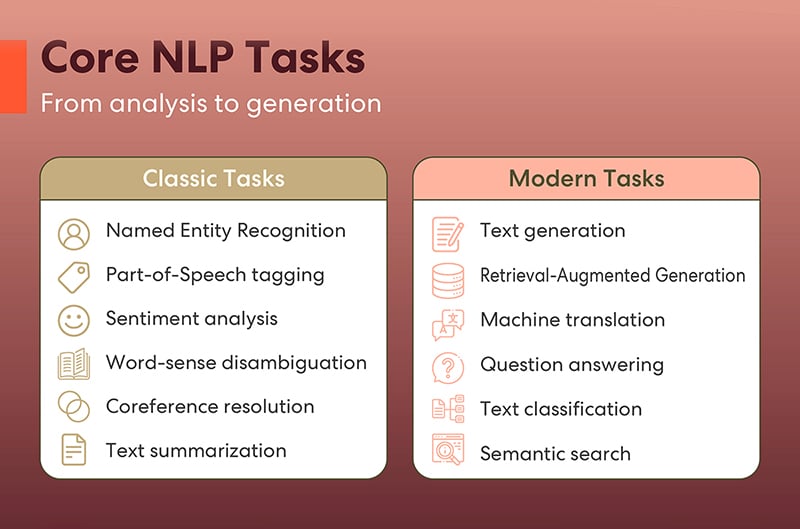
De takenlijst van NLP vertelt het verhaal van de evolutie van het vakgebied.
De klassieke taken draaiden om analyse : het extraheren van namen, bedrijven en datums uit tekst (named entity recognition), het labelen van woordsoorten, het detecteren van sentiment, het bepalen welke betekenis van een woord in de context van toepassing is (word-sense disambiguation), het achterhalen naar welk woord "het" verwijst (coreference resolution) en het samenvatten van lange documenten. Deze taken zijn nog steeds onmisbaar – ze vormen de basis van compliance-systemen, zoekmachines en documentverwerkingssystemen overal ter wereld.
Maar het moderne tijdperk voegde daar generatie aan toe. De systemen van vandaag lezen niet alleen taal, ze produceren het ook: ze stellen teksten op, beantwoorden vragen, vertalen tussen talen, classificeren documenten op grote schaal, maken semantisch zoeken mogelijk dat aansluit op de intentie in plaats van op trefwoorden, en genereren teksten die de zoekresultaten verbeteren — daarover later meer, want dat verdient een eigen plekje in de schijnwerpers.
De verschuiving van analyse naar generatie is de grootste verandering in de geschiedenis van NLP. Machines gingen van het beoordelen van essays naar het schrijven ervan.
De zeven ideeën die NLP momenteel aansturen
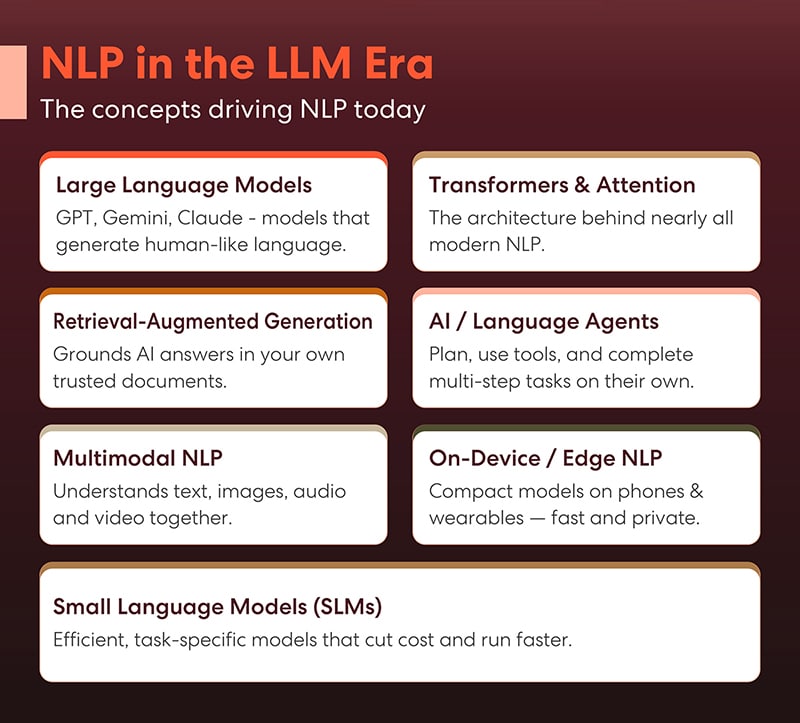
Zeven concepten definiëren het huidige landschap – en als je die kent, kun je elke presentatie van een AI-leverancier in 2026 beter begrijpen.
Grote taalmodellen (LLM's) zijn de absolute blikvangers: GPT, Gemini en Claude genereren mensachtige taal met een vloeiendheid die een paar jaar geleden nog onmogelijk leek. Dankzij hen is NLP van een backoffice-activiteit uitgegroeid tot een onderwerp dat in directievergaderingen ter sprake komt.
Transformers en aandacht vormen de onderliggende mechanismen. Bijna elk modern NLP-systeem – van geavanceerde taalmodellen tot de automatische aanvulling op je telefoon – is gebouwd op deze architectuur, waardoor modellen de context van een volledig document in één keer kunnen afwegen.
Retrieval-Augmented Generation (RAG) is de favoriet van het bedrijf van de zeven methoden, omdat het AI-antwoorden baseert op uw eigen vertrouwde documenten. In plaats van te vertrouwen op het geheugen van een model, laat u het uw geverifieerde kennisbank raadplegen – en hallucinaties nemen drastisch af.
AI en taalagenten tillen modellen van het beantwoorden van vragen naar het voltooien van taken: het plannen van stappen, het aanroepen van tools en het uitvoeren van taken met meerdere stappen met minimale supervisie. Als 2024 het jaar van de chatbots was, lijkt 2026 het jaar van de agenten te worden.
Multimodale NLP vervaagt de grens tussen tekst en al het andere. Moderne systemen verwerken tekst, afbeeldingen, audio en video tegelijk – ze lezen een grafiek, luisteren naar een telefoongesprek en vatten beide samen in één keer.
NLP op het apparaat zelf (edge NLP) plaatst compacte modellen op telefoons en wearables, waar de inferentie lokaal plaatsvindt. Het voordeel is snelheid en privacy: uw gegevens verlaten het apparaat nooit.
Small Language Models (SLM's) vormen de tegenpool van de trend "groter is beter": efficiënte, taakspecifieke modellen die een fractie kosten van een geavanceerd LLM en sneller werken — vaak de slimmere keuze voor een goed gedefinieerde taak.
Waar NLP zijn nut bewijst
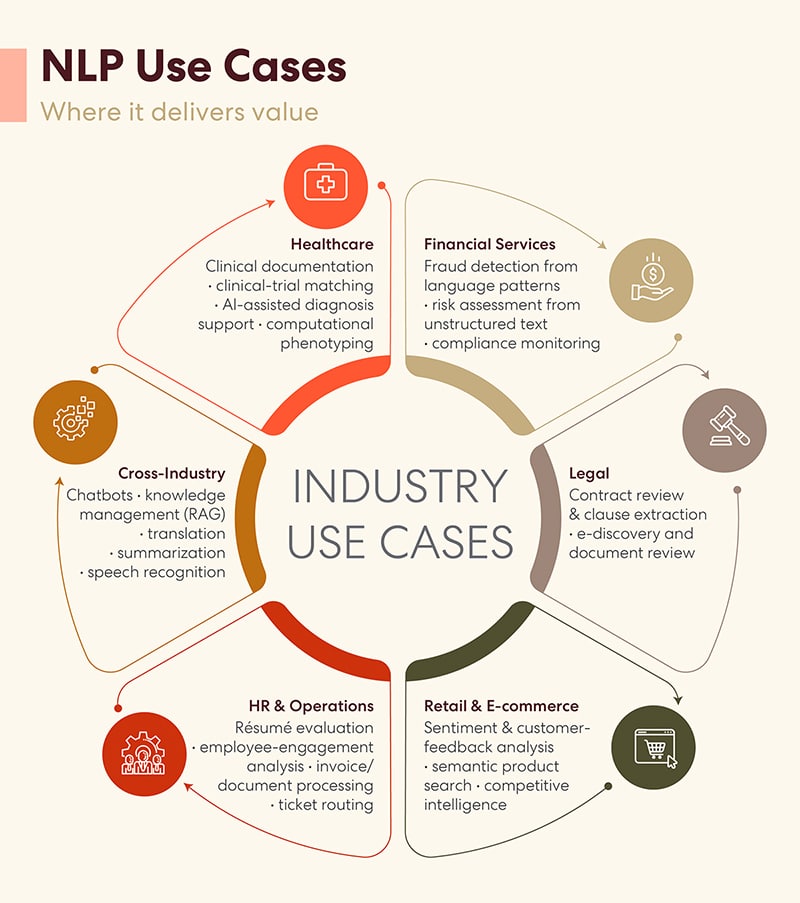
De toepassingsmogelijkheden zijn niet langer speculatief, maar opgenomen in budgetten van diverse sectoren.
In de gezondheidszorg stelt NLP klinische documentatie op (waardoor artsen wekelijks uren besparen), koppelt patiënten aan klinische onderzoeken en ondersteunt diagnoses door aantekeningen te analyseren die een mens op grote schaal niet zou kunnen lezen. In de financiële sector detecteert het fraude aan de hand van taalpatronen en controleert het communicatie op naleving van de regels – een taak die voorheen legioenen beoordelaars vereiste. Juridische teams gebruiken het voor contractbeoordeling, het extraheren van clausules en e-discovery, waardoor weken documentbeoordeling worden teruggebracht tot dagen. Retailers analyseren klantfeedback op sentiment en gebruiken het voor semantisch zoeken dat de intentie begrijpt, niet alleen de trefwoorden. HR- en operationele teams passen het toe op het screenen van cv's, het analyseren van klantbetrokkenheid, het verwerken van facturen en het routeren van tickets.
En dat in elke branche: chatbots, kennismanagement via RAG, vertaling, samenvatting en spraakherkenning. De rode draad is altijd dezelfde: tekst die voorheen onbruikbaar was, wordt data waarmee je actie kunt ondernemen.
Het eerlijke beeld: voordelen en wat er nog steeds misgaat
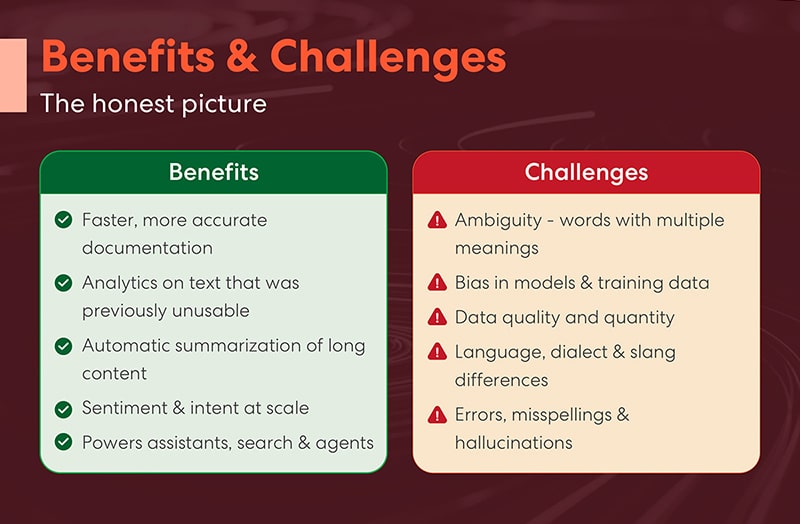
De voordelen hiervan zijn concreet. Documentatie wordt sneller en nauwkeuriger geschreven. Tekst die voorheen onbruikbaar was, wordt analyseerbare data. Lange teksten vatten zichzelf samen. Sentiment en intentie kunnen op grote schaal worden afgelezen over miljoenen interacties. En de hele stack vormt de basis voor de assistenten, zoekmachines en agents waar uw teams al op vertrouwen.
Maar het zou oneerlijk zijn om de tour daar te beëindigen, want NLP kampt in 2026 nog steeds met serieuze problemen.
Taal is ambigu: woorden hebben meerdere betekenissen en modellen struikelen nog steeds over context die ieder mens wel zou herkennen. Modellen erven vooroordelen uit hun trainingsdata, wat ongemerkt invloed kan hebben op wervingsinstrumenten, kredietbeslissingen en contentmoderatie. De kwaliteit van de data blijft het onopvallende knelpunt: modellen zijn slechts zo goed als de data waarop ze leren, en hoogwaardige, goed geannoteerde trainingsdata zijn schaars en duur. Dialecten, straattaal en talen met weinig beschikbare bronnen presteren slechter dan standaard Engels. En hallucinatie – zelfverzekerde, vloeiende, maar onjuiste output – blijft de oorzaak van de problemen die ervoor zorgt dat implementaties in het bedrijfsleven voorzichtig blijven.
Geen van deze punten is een reden om af te haken. Het zijn juist redenen om doordacht te werk te gaan: baseer modellen op geverifieerde data, evalueer ze op je eigen taal en gebruikers , en betrek mensen bij het proces wanneer fouten kostbaar zijn. Opvallend is dat de meeste van deze uitdagingen terug te voeren zijn op dezelfde oorzaak: de data waarop modellen worden getraind en geëvalueerd. Daarom is datakwaliteit een concurrentievoordeel geworden, geen loutere vereiste.
Wat staat ons te wachten: vijf trends om in de gaten te houden tot en met 2026
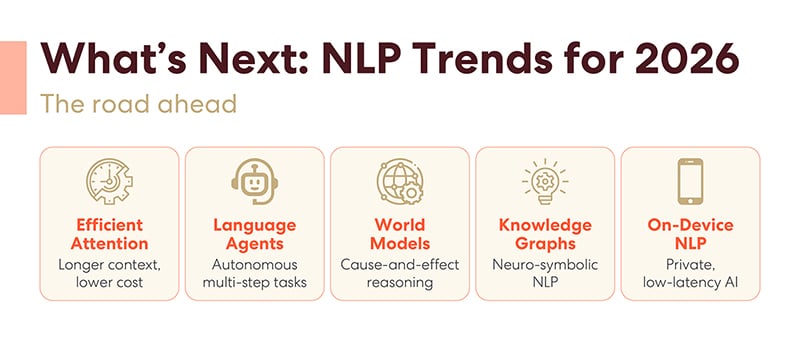
Vooruitkijkend zullen vijf ontwikkelingen de volgende fase van het vakgebied bepalen. Efficiënte aandachtmechanismen vergroten de contextvensters en verlagen tegelijkertijd de kosten, waardoor modellen in één keer over complete codebases of casusbestanden kunnen redeneren. Taalagenten maken de overstap van demo's naar productie en verwerken zelfstandig workflows met meerdere stappen. Wereldmodellen streven ernaar AI te voorzien van echte oorzaak-gevolgredeneringen in plaats van patroonherkenning. Kennisgrafieken worden samengevoegd met neurale benaderingen – neuro-symbolische NLP – om de modeluitvoer feitelijker en controleerbaarder te maken. En NLP op apparaten zorgt ervoor dat krachtige modellen steeds kleiner worden, totdat privé-AI met lage latentie in je zak past.
Het patroon bij alle vijf is hetzelfde: minder brute kracht, meer precisie. Goedkoper, sneller, meer realistisch, dichter bij de gebruiker.
The Bottom Line
NLP is in 2026 geen opkomende technologie meer, maar infrastructuur, net zo vanzelfsprekend en onmisbaar als databases. De organisaties die vooroplopen, vragen zich niet af of ze NLP moeten gebruiken, maar welke taken ze als eerste moeten automatiseren, hoe ze modellen moeten baseren op hun eigen data en hoe ze ervoor kunnen zorgen dat de trainingsdata die eraan ten grondslag liggen, waardevol zijn om van te leren.