
Er schuilt een stille ironie in de kern van AI voor bedrijven: de slimste modellen ter wereld kunnen je niet helpen als je data vastzit in een gescande factuur, een gefaxt laboratoriumrapport of een handgeschreven leveringsbon. En naar schatting 80% van de bedrijfsdata bevindt zich precies in dit soort ongestructureerde documenten.
Optische tekenherkenning (OCR) is de technologie die die data vrijmaakt. En in 2026 beleeft het een bloeiperiode. De wereldwijde OCR-markt zal naar verwachting $55.3 miljard bereiken in 2033, een stijging ten opzichte van $13.1 miljard in 2023, met een groei van 15.5% per jaar. Moderne OCR-systemen behalen routinematig een nauwkeurigheid van 98-99% op paginaniveau. Wat ooit een omslachtig scanprogramma was, is uitgegroeid tot de toegangspoort tot bedrijfsautomatisering.
Zo ziet OCR er vandaag de dag uit: hoe het werkt, de verschillende typen die er zijn, wat AI heeft veranderd en waar het naartoe gaat.
Wat is OCR?
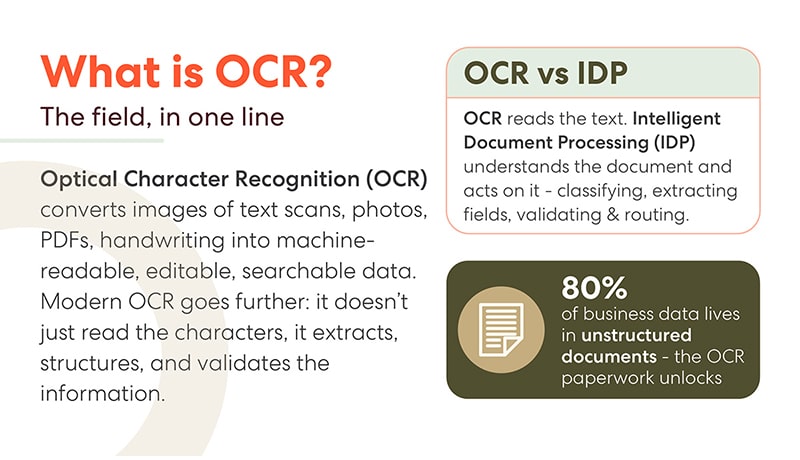
Optische tekenherkenning (OCR) zet afbeeldingen van tekst – scans, foto's, pdf's, handgeschreven tekst – om in machineleesbare, bewerkbare en doorzoekbare gegevens. Dat is de definitie zoals die in leerboeken staat, maar die doet geen recht aan wat er in 2026 werkelijk gebeurt.
Moderne OCR leest niet alleen tekens. Het extraheert structuren – velden, tabellen, regelitems – en valideert de informatie die het eruit haalt. Voer een verfrommelde factuur in die met een telefoon is gefotografeerd, en het levert geen brij van tekst op, maar een gestructureerd record: leverancier, datum, regelitems, totaal, elk met een betrouwbaarheidsscore.
OCR versus IDP: een belangrijk verschil
Je hoort beide termen in elk gesprek met een leverancier, dus hier is het verschil. OCR leest de tekst. Intelligent Document Processing (IDP) begrijpt het document en verwerkt het : het classificeert het type document, extraheert de relevante velden, valideert deze aan de hand van bedrijfsregels en stuurt het resultaat door naar het juiste systeem.
Zie OCR als de ogen en IDP als de hersenen. Zonder de een kom je maar halverwege: perfect getranscribeerde tekst die nog steeds door een mens moet worden geïnterpreteerd, of een slimme workflow die geen leesbare input krijgt. De markt beweegt zich duidelijk richting de combinatie.
Hoe OCR werkt: het moderne 6-stappenproces
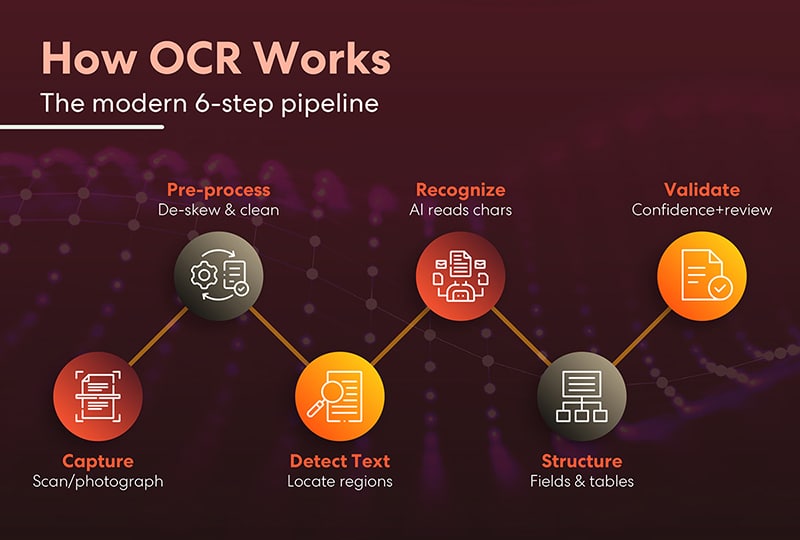
De huidige OCR-systemen doorlopen een proces in zes stappen, en inzicht daarin helpt verklaren waarom de nauwkeurigheid zo sterk is verbeterd en waar fouten nog steeds insluipen.
Het begint met het vastleggen van het document: een scan of foto ervan. Vervolgens wordt de afbeelding voorbewerkt : scheefstaande pagina's worden rechtgetrokken, ruis wordt verwijderd en het contrast wordt gecorrigeerd, want de kwaliteit van de herkenning hangt af van de kwaliteit van de afbeelding waarmee het begint. Daarna lokaliseert tekstdetectie de delen van de pagina die daadwerkelijk tekst bevatten, waarbij woorden worden gescheiden van logo's, stempels en de achtergrond. Dan volgt de herkenning , waarbij AI de tekens leest – de stap die de meeste mensen kennen als "OCR". Maar de moderne pipeline stopt daar niet. Structurering zet de ruwe tekst om in velden en tabellen, waardoor "woorden op een pagina" worden omgezet in "data in een schema". Ten slotte past validatie een betrouwbaarheidsscore en beoordeling toe, waarbij alles wat onduidelijk is, wordt gemarkeerd voor een menselijke controle voordat het in uw systemen terechtkomt.
Vastleggen → voorbewerken → detecteren → herkennen → structureren → valideren. De laatste twee stappen onderscheiden OCR van 2026 van de scansoftware van tien jaar geleden.
Soorten OCR: Niet alle herkenning is hetzelfde
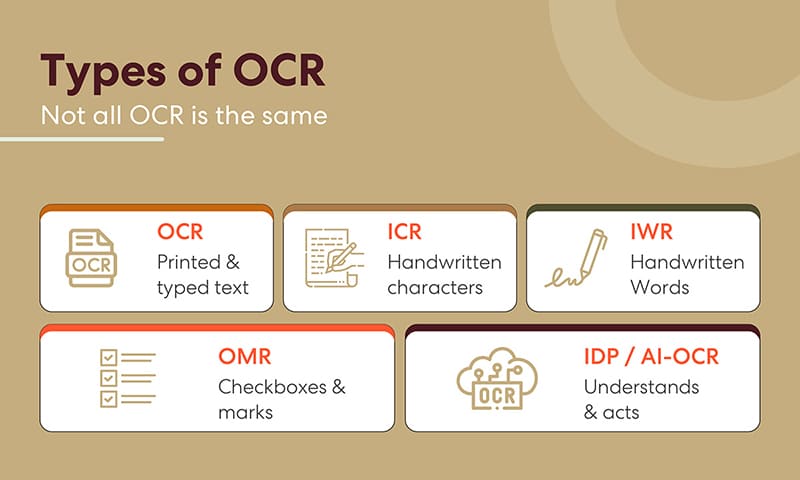
"OCR" wordt vaak als overkoepelende term gebruikt, maar het vakgebied onderscheidt verschillende technologieën, elk geschikt voor verschillende soorten content.
OCR (Optical Character Recognition) verwerkt gedrukte en getypte tekst – het eenvoudigste en meest geavanceerde geval. ICR (Intelligent Character Recognition) leest handgeschreven tekens, een van de moeilijkste problemen in het vakgebied. IWR (Intelligent Word Recognition) gaat een stap verder en herkent complete handgeschreven woorden in plaats van individuele letters – beter geschikt voor cursief schrift, waar tekens in elkaar overlopen. OMR (Optical Mark Recognition) leest selectievakjes en markeringen, de technologie achter formulieren en antwoordbladen. En IDP/AI-OCR staat bovenaan de ladder: systemen die niet alleen lezen, maar ook begrijpen en ernaar handelen.
Weten welk type OCR-verwerking nodig is, is de eerste vraag bij elk OCR-project. Een geprinte factuur en een handgeschreven recept van een arts zijn totaal verschillende problemen.
OCR in het AI-tijdperk: Ruwe OCR is nu slechts de eerste stap.
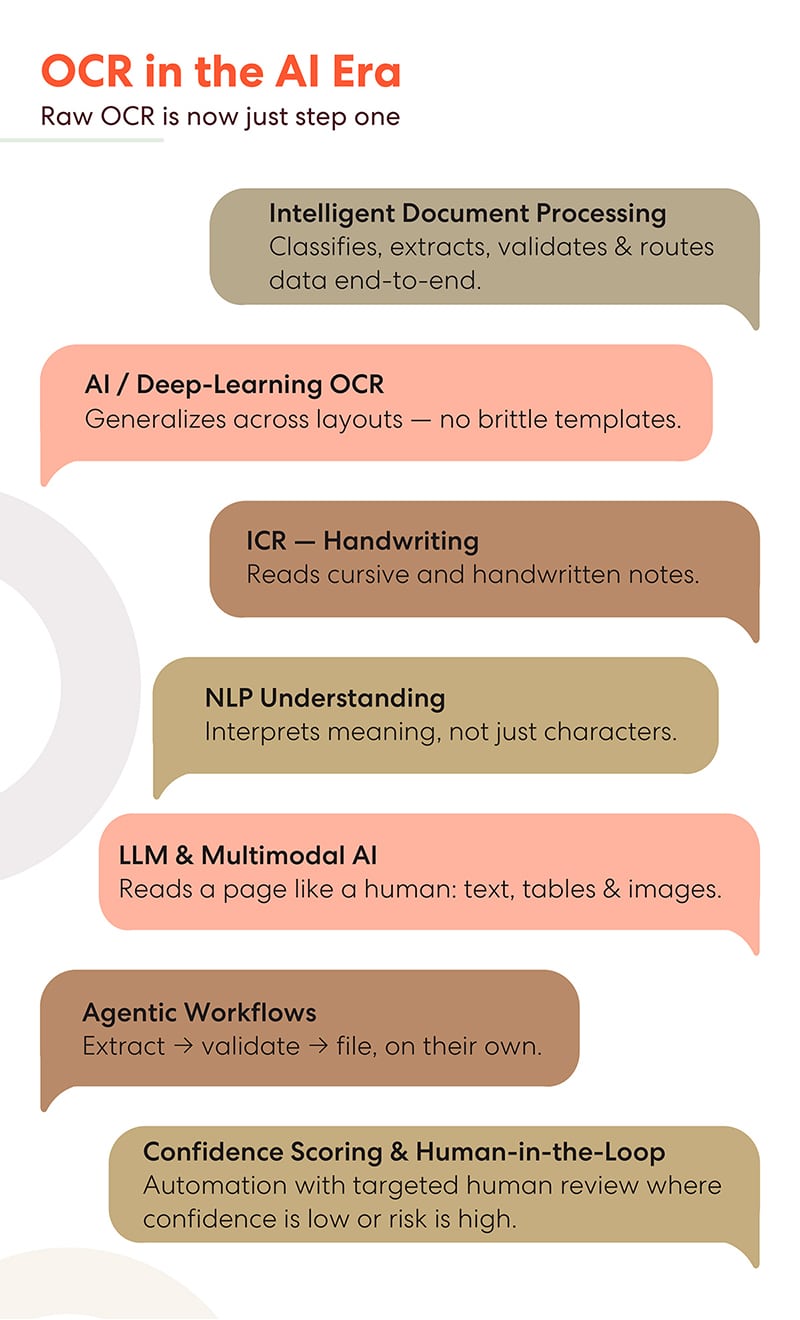
De grootste verandering in het vakgebied is dat tekenherkenning – ooit het complete product – nu slechts het instapniveau vormt. Zeven functionaliteiten definiëren moderne document-AI.
Intelligente documentverwerking voert het volledige proces van begin tot eind uit: het classificeren van documenten, het extraheren van velden, het valideren van gegevens en het routeren van resultaten, zonder handmatige overdracht.
AI en deep learning OCR generaliseren over verschillende lay-outs. Oudere systemen hadden een strikt sjabloon nodig voor elk documentformaat; moderne modellen verwerken facturen die ze nog nooit eerder hebben gezien, omdat ze hebben geleerd hoe facturen er in het algemeen uitzien.
ICR-handschriftherkenning is inmiddels zo ver gevorderd dat het zowel cursief als handgeschreven notities kan lezen. Hierdoor zijn medische dossiers, leveringsbonnen en archiefdocumenten die voorheen ontoegankelijk waren, nu wel toegankelijk.
NLP begrijpt betekenis, niet alleen tekens. Het systeem transcribeert niet zomaar "Net 30" — het weet dat dit een betalingstermijn is.
LLM's en multimodale AI lezen een pagina zoals een mens dat doet: tekst, tabellen en afbeeldingen samen, in context. Dit is de nieuwste en snelst evoluerende laag van de technologie-architectuur.
Agentische workflows sluiten de cirkel: extractie → validatie → archivering, volledig autonoom. Het document wordt niet alleen gelezen, maar ook verwerkt.
Door middel van betrouwbaarheidsbeoordeling met menselijke tussenkomst kunnen al deze processen veilig worden geïmplementeerd. Automatisering vindt plaats waar de betrouwbaarheid hoog is; menselijke controle vindt alleen plaats waar de betrouwbaarheid laag is of het risico hoog is. Dit model met gerichte controle biedt bedrijven zowel snelheid als traceerbaarheid.
Gebruiksscenario's voor OCR: Waar het waarde oplevert
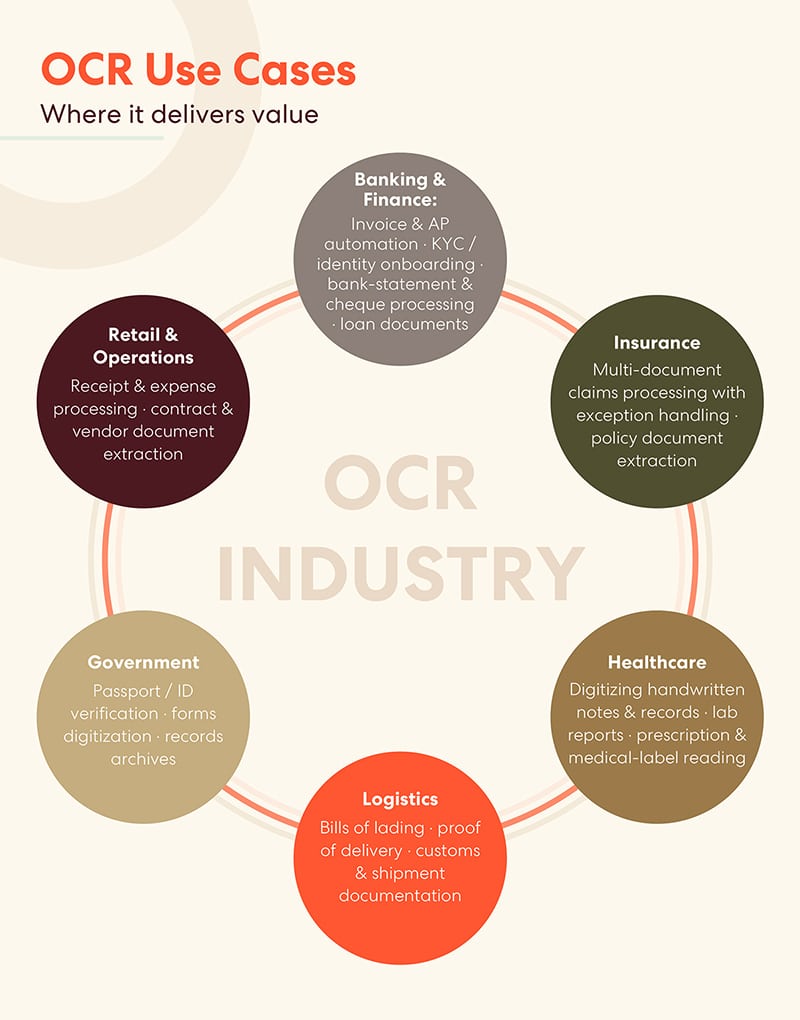
De sectoren die OCR het snelst implementeren, zijn juist de sectoren die overspoeld worden met papier.
De bank- en financiële sector is marktleider op het gebied van OCR-automatisering, zoals factuur- en crediteurenadministratie, KYC- en identiteitsverificatie, en de verwerking van bankafschriften en cheques. Het is geen toeval dat deze sector de grootste OCR-verticale markt vertegenwoordigt, met ongeveer 21%. Verzekeringsmaatschappijen gebruiken het voor de verwerking van claims met meerdere documenten, inclusief uitzonderingsafhandeling en het extraheren van polisdocumenten. Een enkele claim kan tientallen documenten in verschillende formaten bevatten. In de gezondheidszorg digitaliseert OCR handgeschreven notities en dossiers, leest laboratoriumrapporten en verwerkt recepten en medische etiketten, waar nauwkeurigheid letterlijk een veiligheidskwestie is. Logistiek draait op documenten – vrachtbrieven, leveringsbewijzen, douane- en verzenddocumenten – en OCR zorgt ervoor dat goederen blijven bewegen door te voorkomen dat papierwerk een knelpunt wordt. De overheid past het toe voor paspoort- en identiteitsverificatie, formulierverwerking en het digitaliseren van archiefmateriaal. En in de detailhandel en operationele processen wordt het gebruikt voor de verwerking van bonnen en onkosten, en het extraheren van contract- en leveranciersdocumenten.
Het patroon bij alle zes is als volgt: waar voorheen mensen informatie van papier handmatig in een systeem overtypten, doet OCR dat nu sneller, goedkoper en met een traceerbaar controletraject.
Voordelen en uitdagingen: Het eerlijke beeld
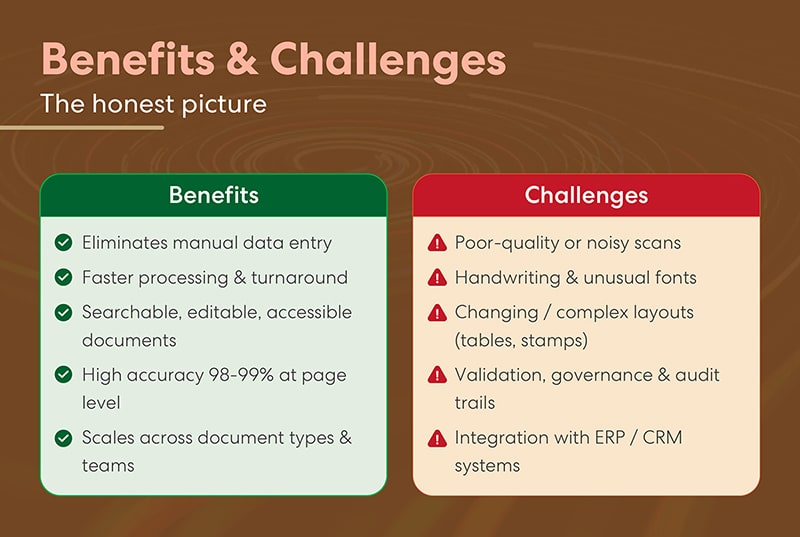
De voordelen zijn concreet. OCR maakt handmatige gegevensinvoer overbodig – de meest foutgevoelige en minst geliefde taak in elke backoffice. De verwerking en doorlooptijd worden aanzienlijk sneller. Documenten worden doorzoekbaar, bewerkbaar en toegankelijk in plaats van dode scans. De nauwkeurigheid bereikt nu 98-99% op paginaniveau. En moderne systemen schalen mee met verschillende documenttypen en -formaten, in plaats van vast te lopen op onbekende gegevens.
Maar daadwerkelijke implementaties stuiten nog steeds op echte problemen. Scans van slechte kwaliteit of met ruis blijven de grootste boosdoener voor de nauwkeurigheid – geen enkel model leest wat niet leesbaar is. Handschrift en ongebruikelijke lettertypen blijven achter bij gedrukte tekst. Veranderende en complexe lay-outs – geneste tabellen, stempels, formulieren met meerdere kolommen – bemoeilijken de extractie. Validatie, governance en audit trails vereisen aanzienlijke technische inspanning, vooral in gereguleerde sectoren. En integratie met ERP- en CRM-systemen is waar veel projecten vastlopen: het extraheren van de data is alleen nuttig als deze terechtkomt waar het werk daadwerkelijk plaatsvindt.
Geen van deze punten is doorslaggevend. Ze zijn juist de reden waarom betrouwbaarheidsscores en menselijke beoordeling bestaan – en waarom de kwaliteit van documenten en goed geannoteerde trainingsdata net zo belangrijk zijn als de modelkeuze.
De OCR-markt: bronnen en actuele informatie
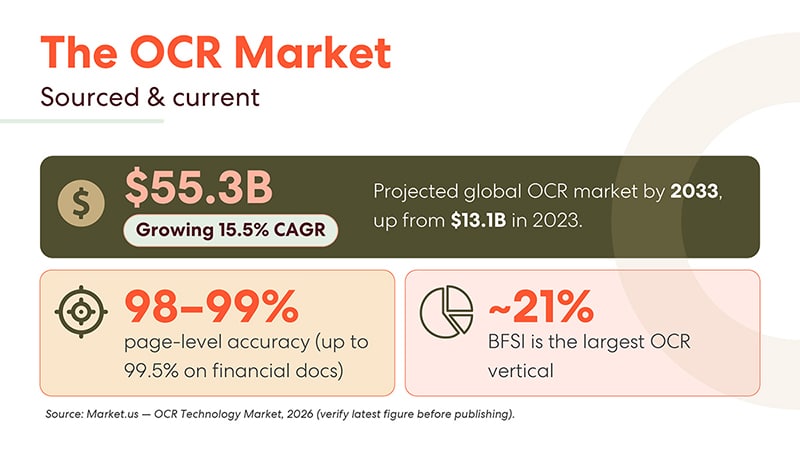
De cijfers illustreren de kansen. De wereldwijde OCR-markt zal naar verwachting in 2033 een waarde van $ 55.3 miljard bereiken , tegenover $ 13.1 miljard in 2023 – een samengestelde jaarlijkse groei van 15.5% . De nauwkeurigheid op paginaniveau heeft 98-99% bereikt en stijgt nog verder bij financiële documenten. De BFSI-sector (Banking, Financial Services and Insurance) is met circa 21% van de markt de grootste sector , een indicatie dat daar het rendement op investering (ROI) zich het eerst bewijst.
Wat staat ons te wachten: OCR-trends voor 2026
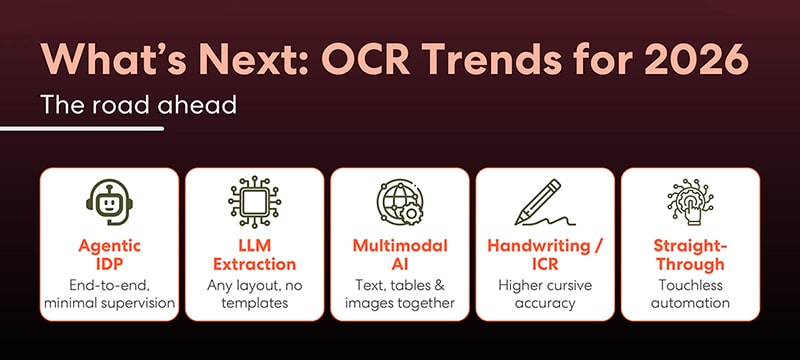
Vijf trends bepalen de weg vooruit. Agentic IDP — documentworkflows die van begin tot eind volledig geautomatiseerd zijn, zonder menselijke tussenkomst. LLM-gestuurde extractie — gebruikmakend van grote taalmodellen om gestructureerde data uit documenten te halen met minimale of geen sjabloonconfiguratie. Multimodale AI — modellen die tekst, tabellen en afbeeldingen in één keer verwerken en documenten als geheel begrijpen in plaats van als fragmenten. Verbeteringen in handschrift- en ICR-herkenning — een gestaag toenemende nauwkeurigheid bij cursief en onleesbaar handschrift, waardoor documentcategorieën die voorheen alleen handmatig verwerkt konden worden, nu toegankelijk zijn. En straight-through processing — het einddoel: documenten die binnenkomen, gelezen, gevalideerd en gearchiveerd worden zonder menselijke tussenkomst.
De richting is onmiskenbaar: van het lezen van documenten naar het verwerken ervan.
The Bottom Line
OCR in 2026 draait niet langer om het omzetten van afbeeldingen naar tekst, maar om het omzetten van documenten in afgerond werk. Met 80% van de bedrijfsgegevens opgesloten in ongestructureerde documenten en een markt die richting de $55 miljard gaat, is de vraag voor de meeste organisaties niet of ze OCR moeten implementeren, maar hoe ver ze daarin moeten gaan: van het extraheren van platte tekst tot gestructureerde IDP (Intelligent Data Processing) of volledig geautomatiseerde documentworkflows.
De documenten stapelen zich al op. De technologie om ze te lezen – en ernaar te handelen – is gereed.